【译】Anthropic:智能体记忆的组成部分
本文翻译自Anthropic官方博客,原文链接:link.
Søren Kierkegaard曾写道,生命只能回首理解,却必须向前体验。我们在为人工智能体设计记忆时也遇到了类似的困境。
作为人类,我们在日常生活中不断地对记忆进行编码。海马体在这一过程中扮演着核心角色,它能捕捉当下的体验,使记忆迅速形成并即时可用。但只有部分体验会被巩固为长期记忆。
大部分的记忆巩固似乎发生在我们的大脑处于离线状态时。当我们睡觉或安静休息时,海马体会重现我们最近的经历。人们认为这会逐渐提炼这些经历,并将它们整合到新皮层——我们大脑中储存大部分我们称之为知识的部分。
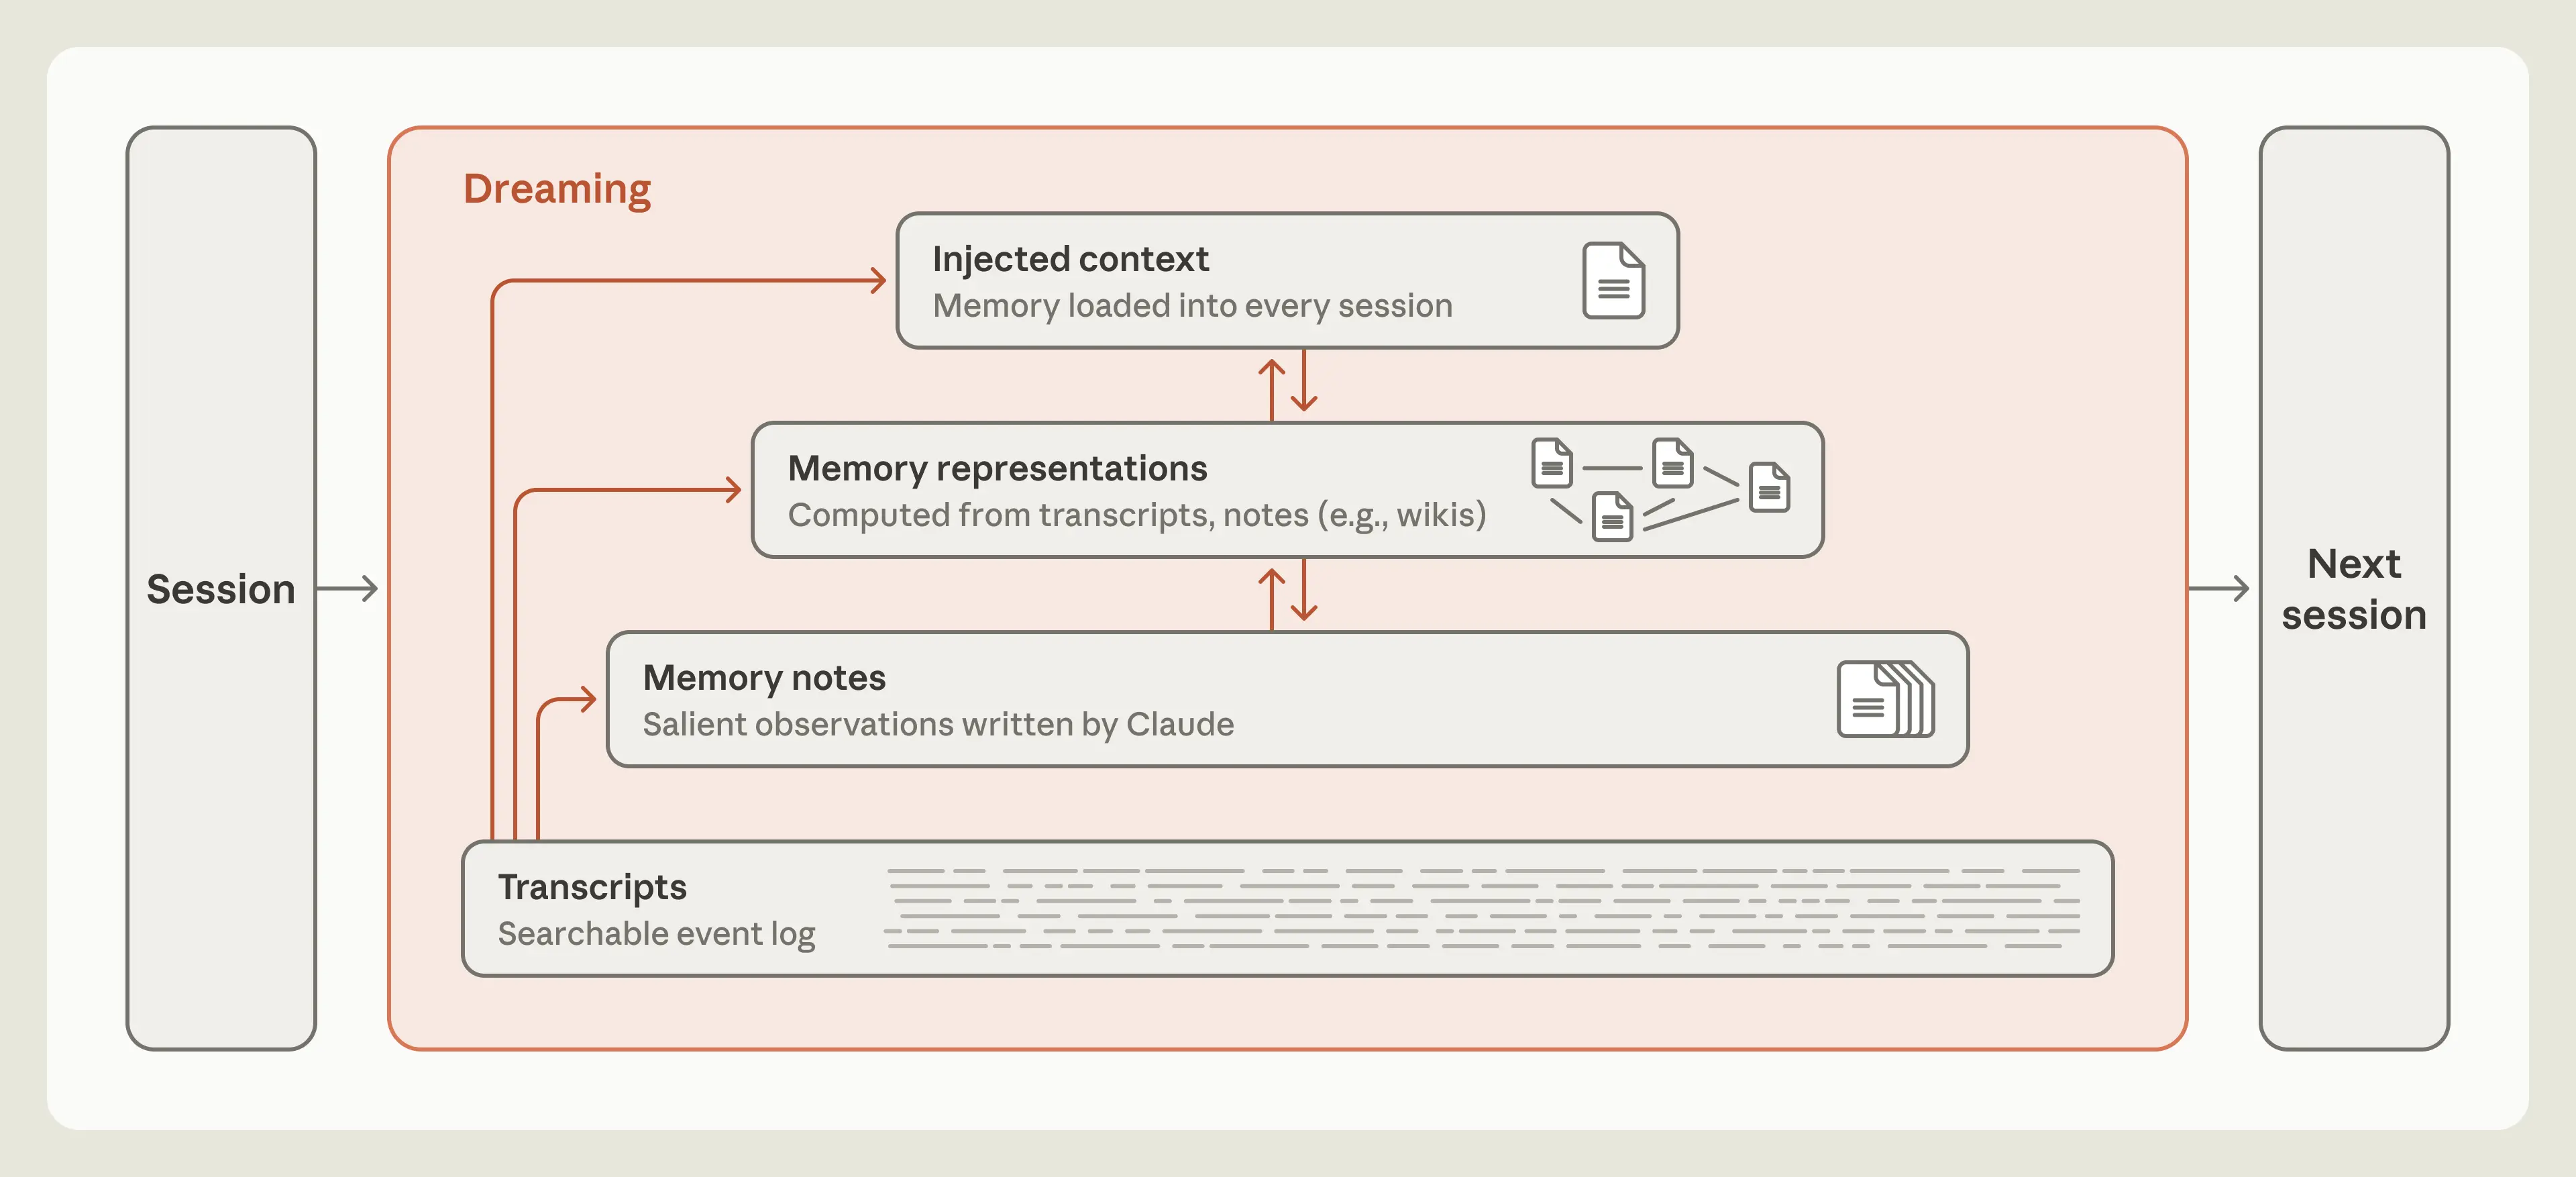
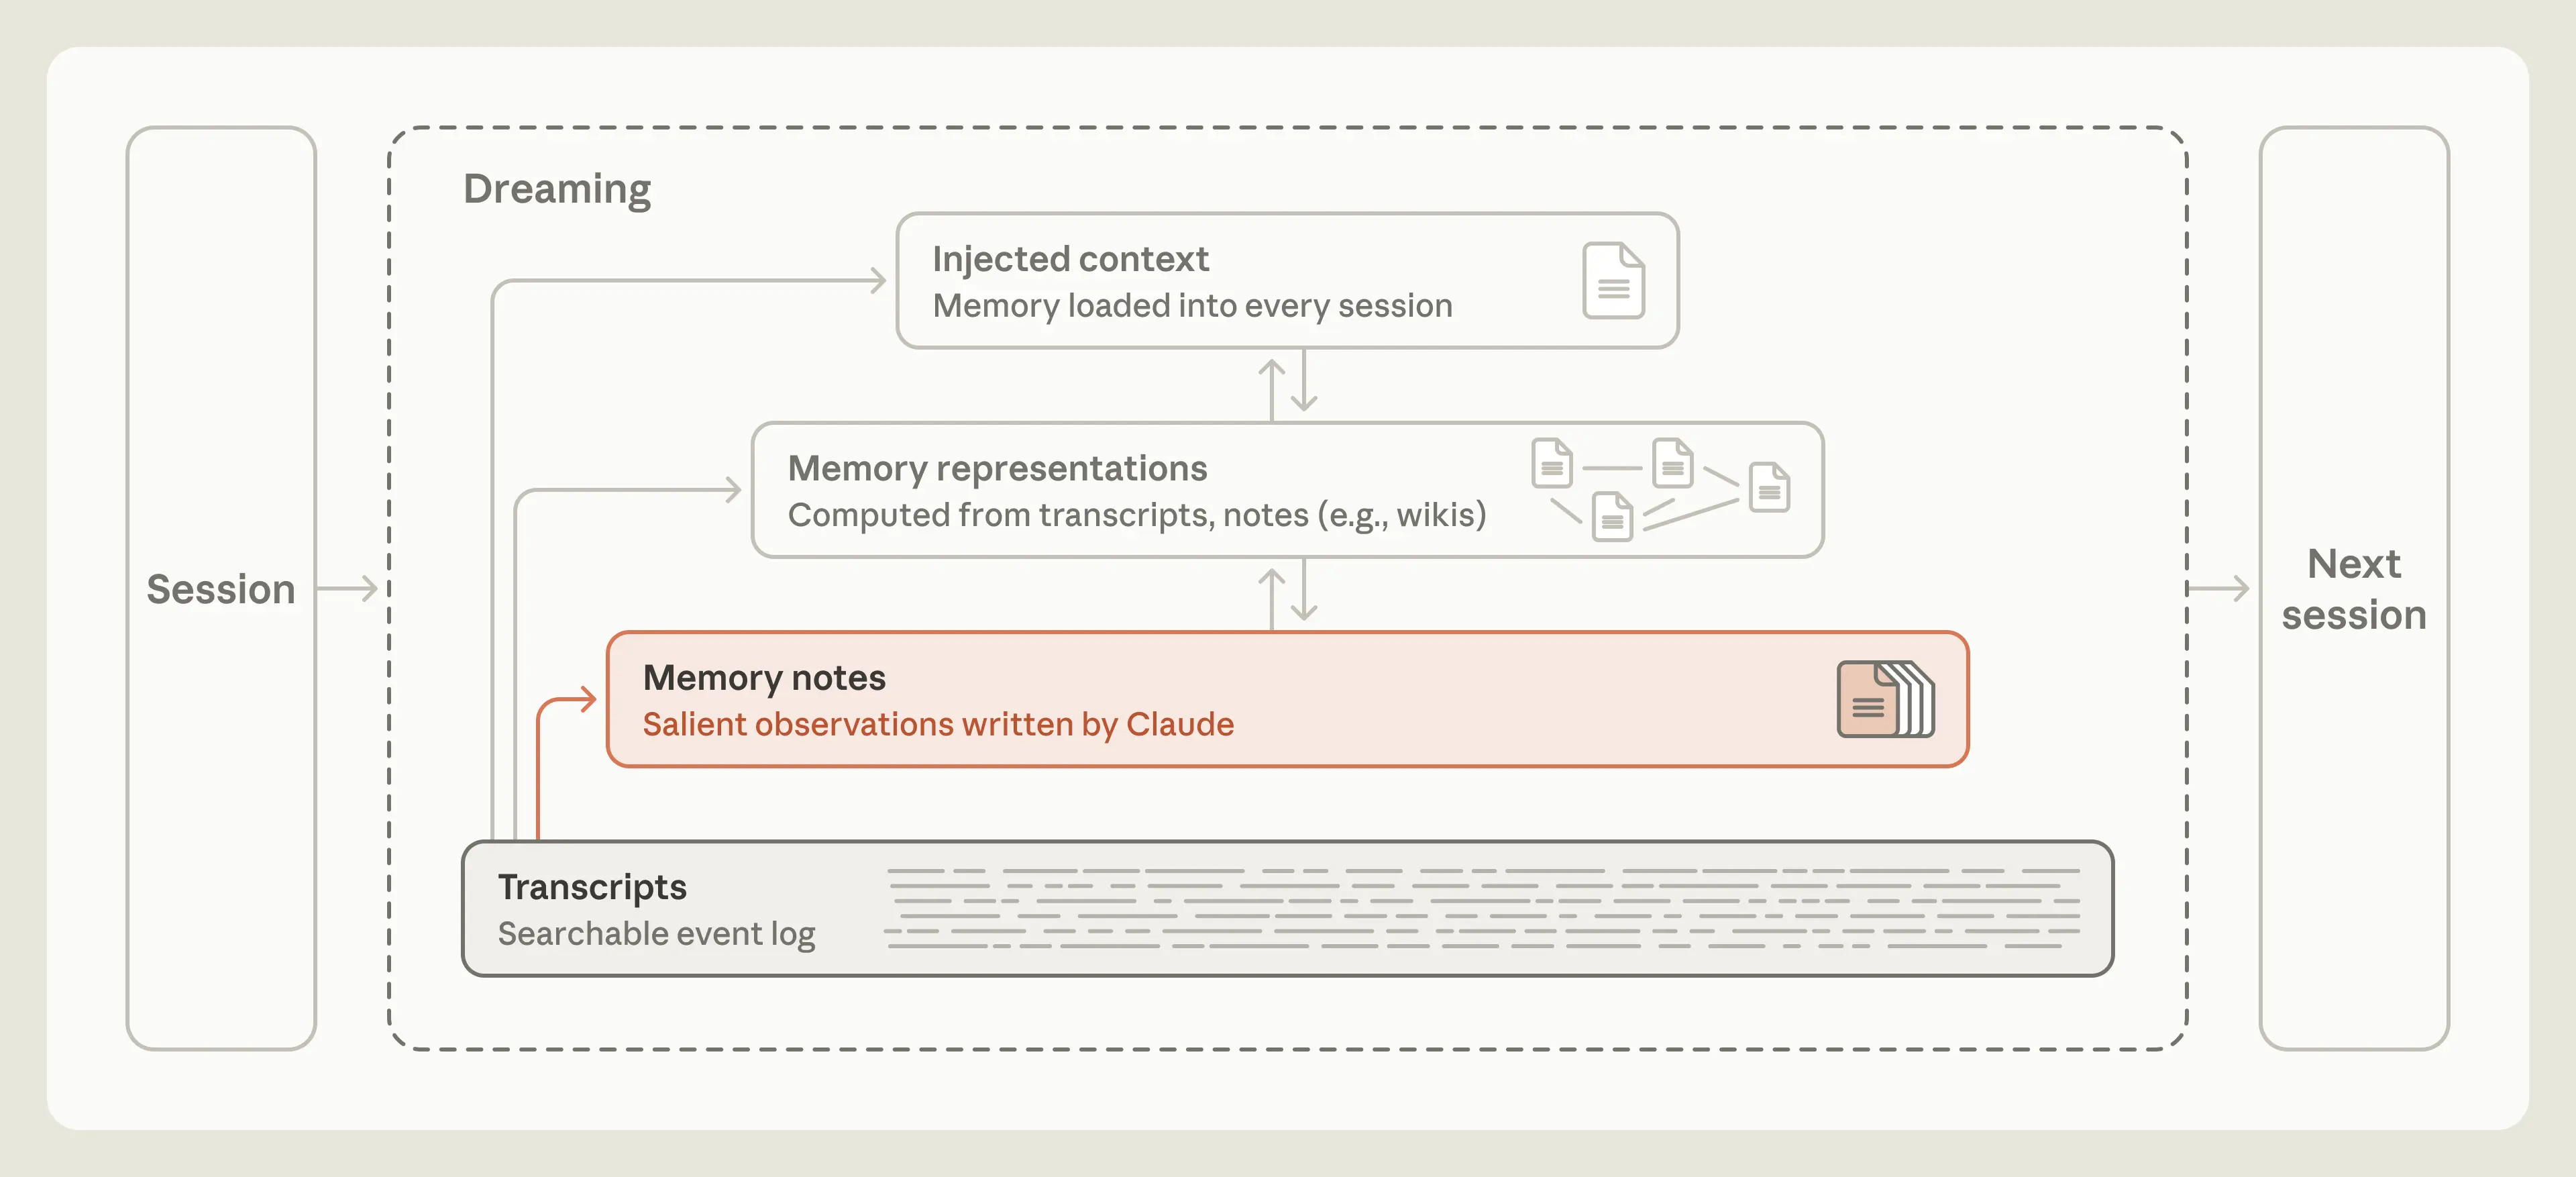
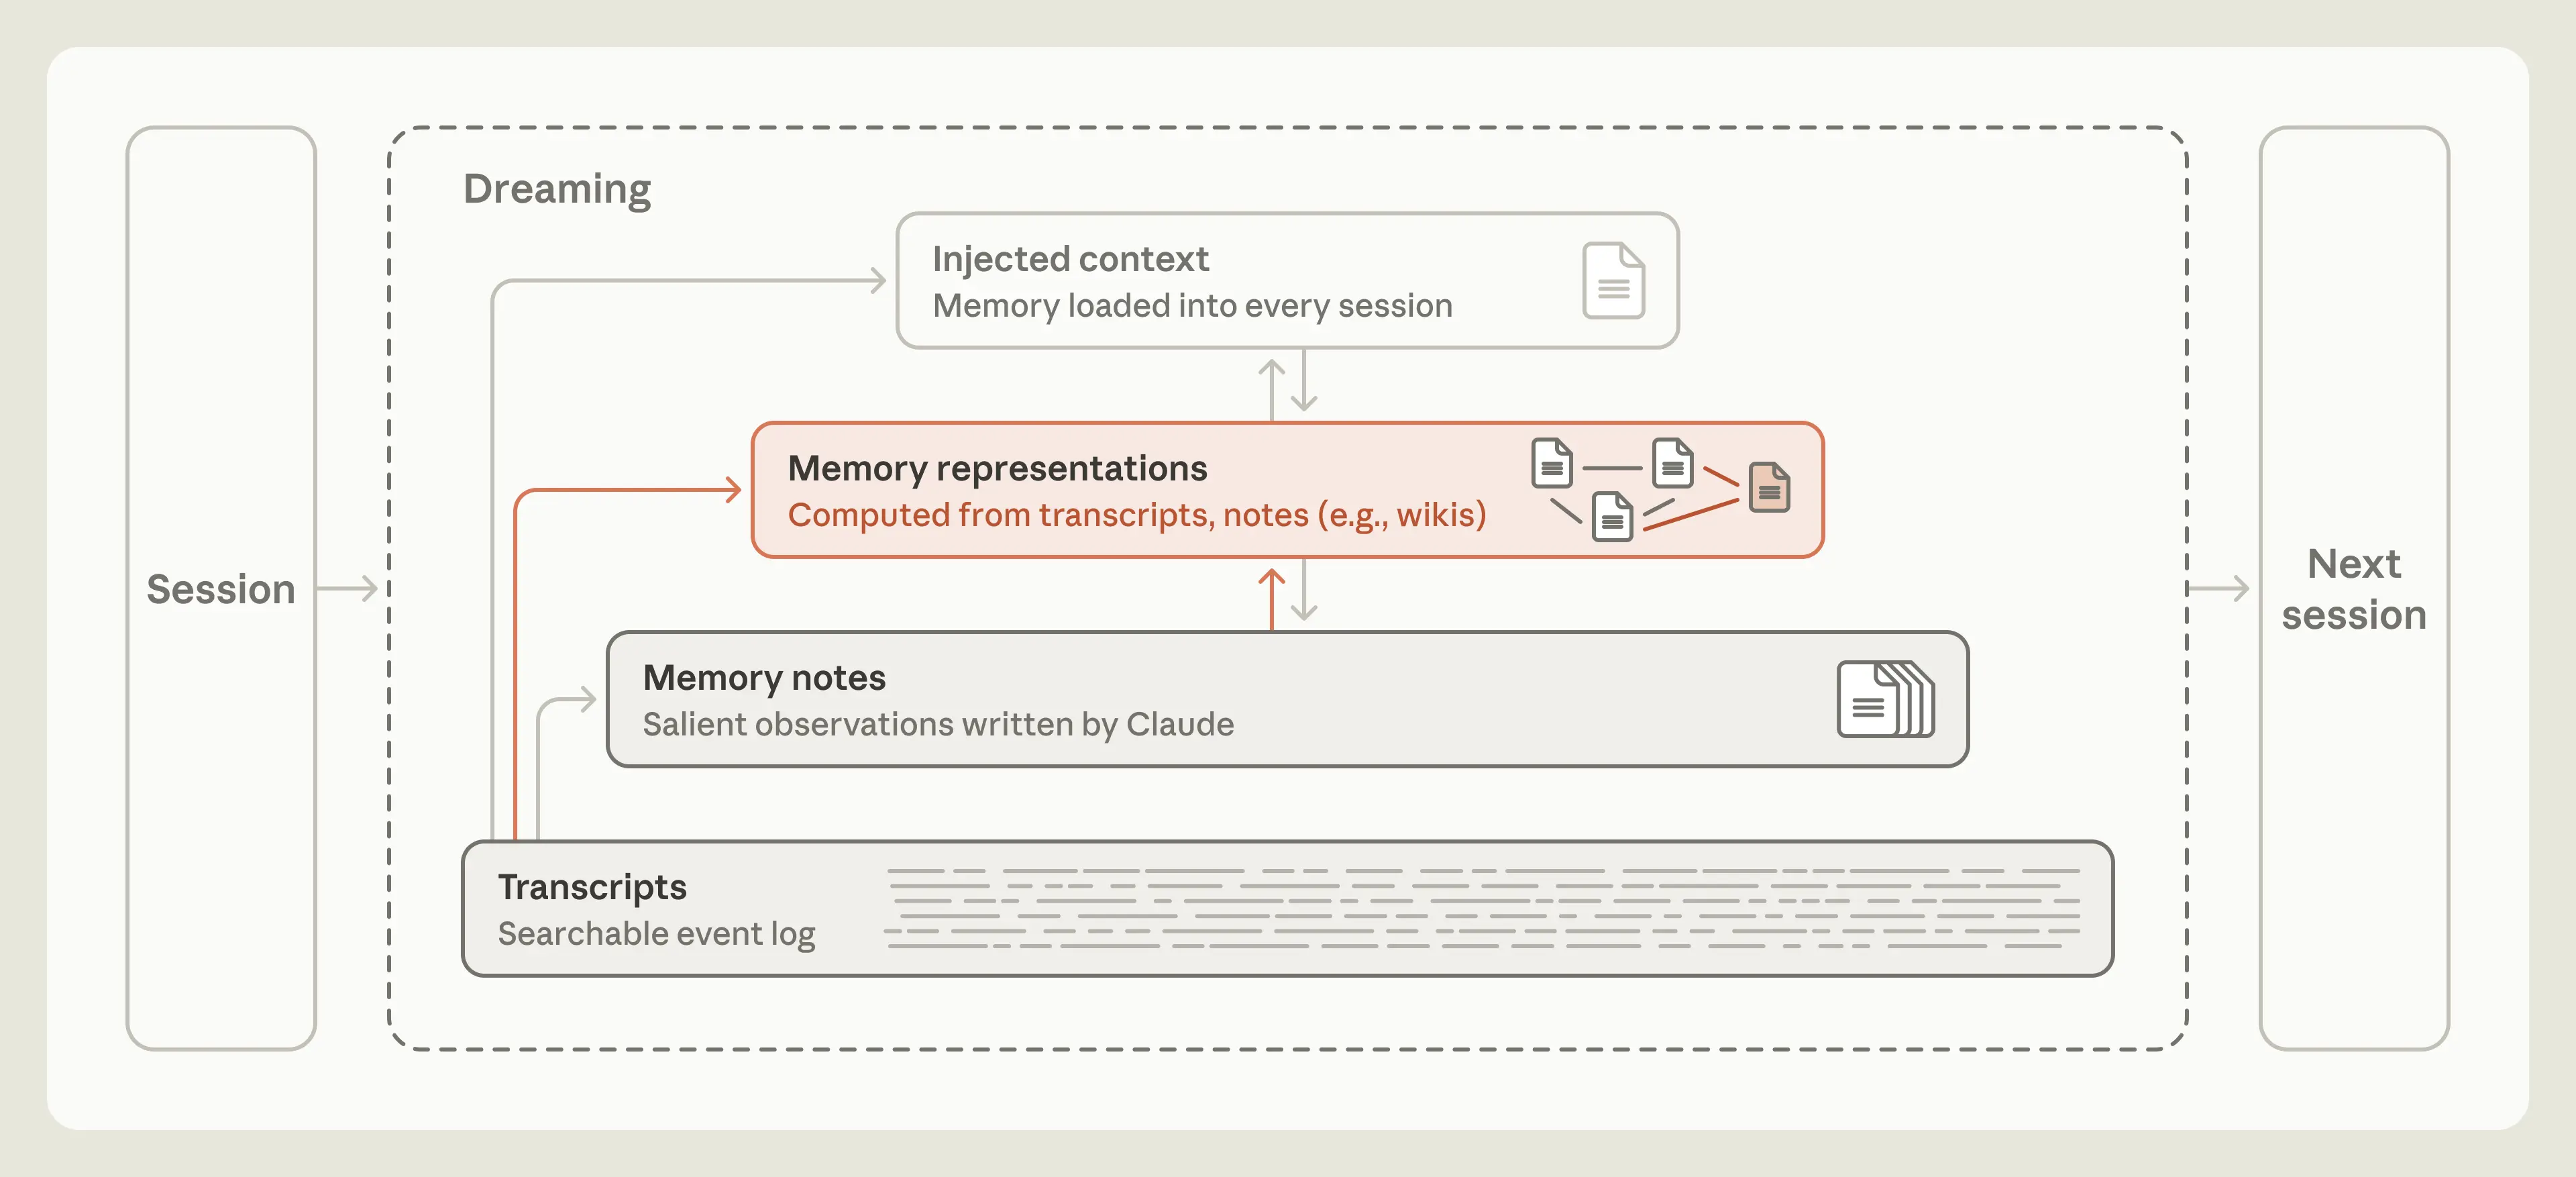
智能体记忆也可以采用类似的分工方式。智能体会将大部分工作记录在日志或转录文本中。Letta 和加州大学伯克利分校的研究人员提出了睡眠时间计算的概念,让模型能够利用交互之间的空闲时间来重组其现有上下文。同样的思路也可以帮助智能体通过反思日志来组织记忆,从而修正错误或生成新的笔记和表征。这个过程通常被称为 “梦境”(图 1)。
我们发现,梦境是帮助我们赋予 Claude 有效记忆的有效工具。在这篇文章中,我们将分享我们如何思考智能体记忆,并详细介绍我们用于探索智能体记忆的几种评估方法,包括梦境的应用,以及每个组成部分对记忆组织的贡献。
记忆笔记
所谓“智能体记忆”,指的是 Claude 从经验中获得的知识——包括与用户的互动以及它被分配的任务——并且它在会话之间保留这些知识,以上下文的形式保存下来,以便稍后读取。它不包括模型学习或管理上下文的其他方式,例如更改权重(训练期间设置的内部参数)、上下文学习(在单个对话中获得的知识)以及压缩(Claude 编写的摘要,用于替换其旧的对话回合,以便它可以在新的上下文窗口中继续工作)。
在人脑中,经历之前、之中或之后释放的化学信号可以将记忆标记为重要。在离线期间,被标记的记忆比未被标记的记忆更容易被重现。这个过程被称为重现,它有助于稳定记忆并将其整合到长期记忆中。
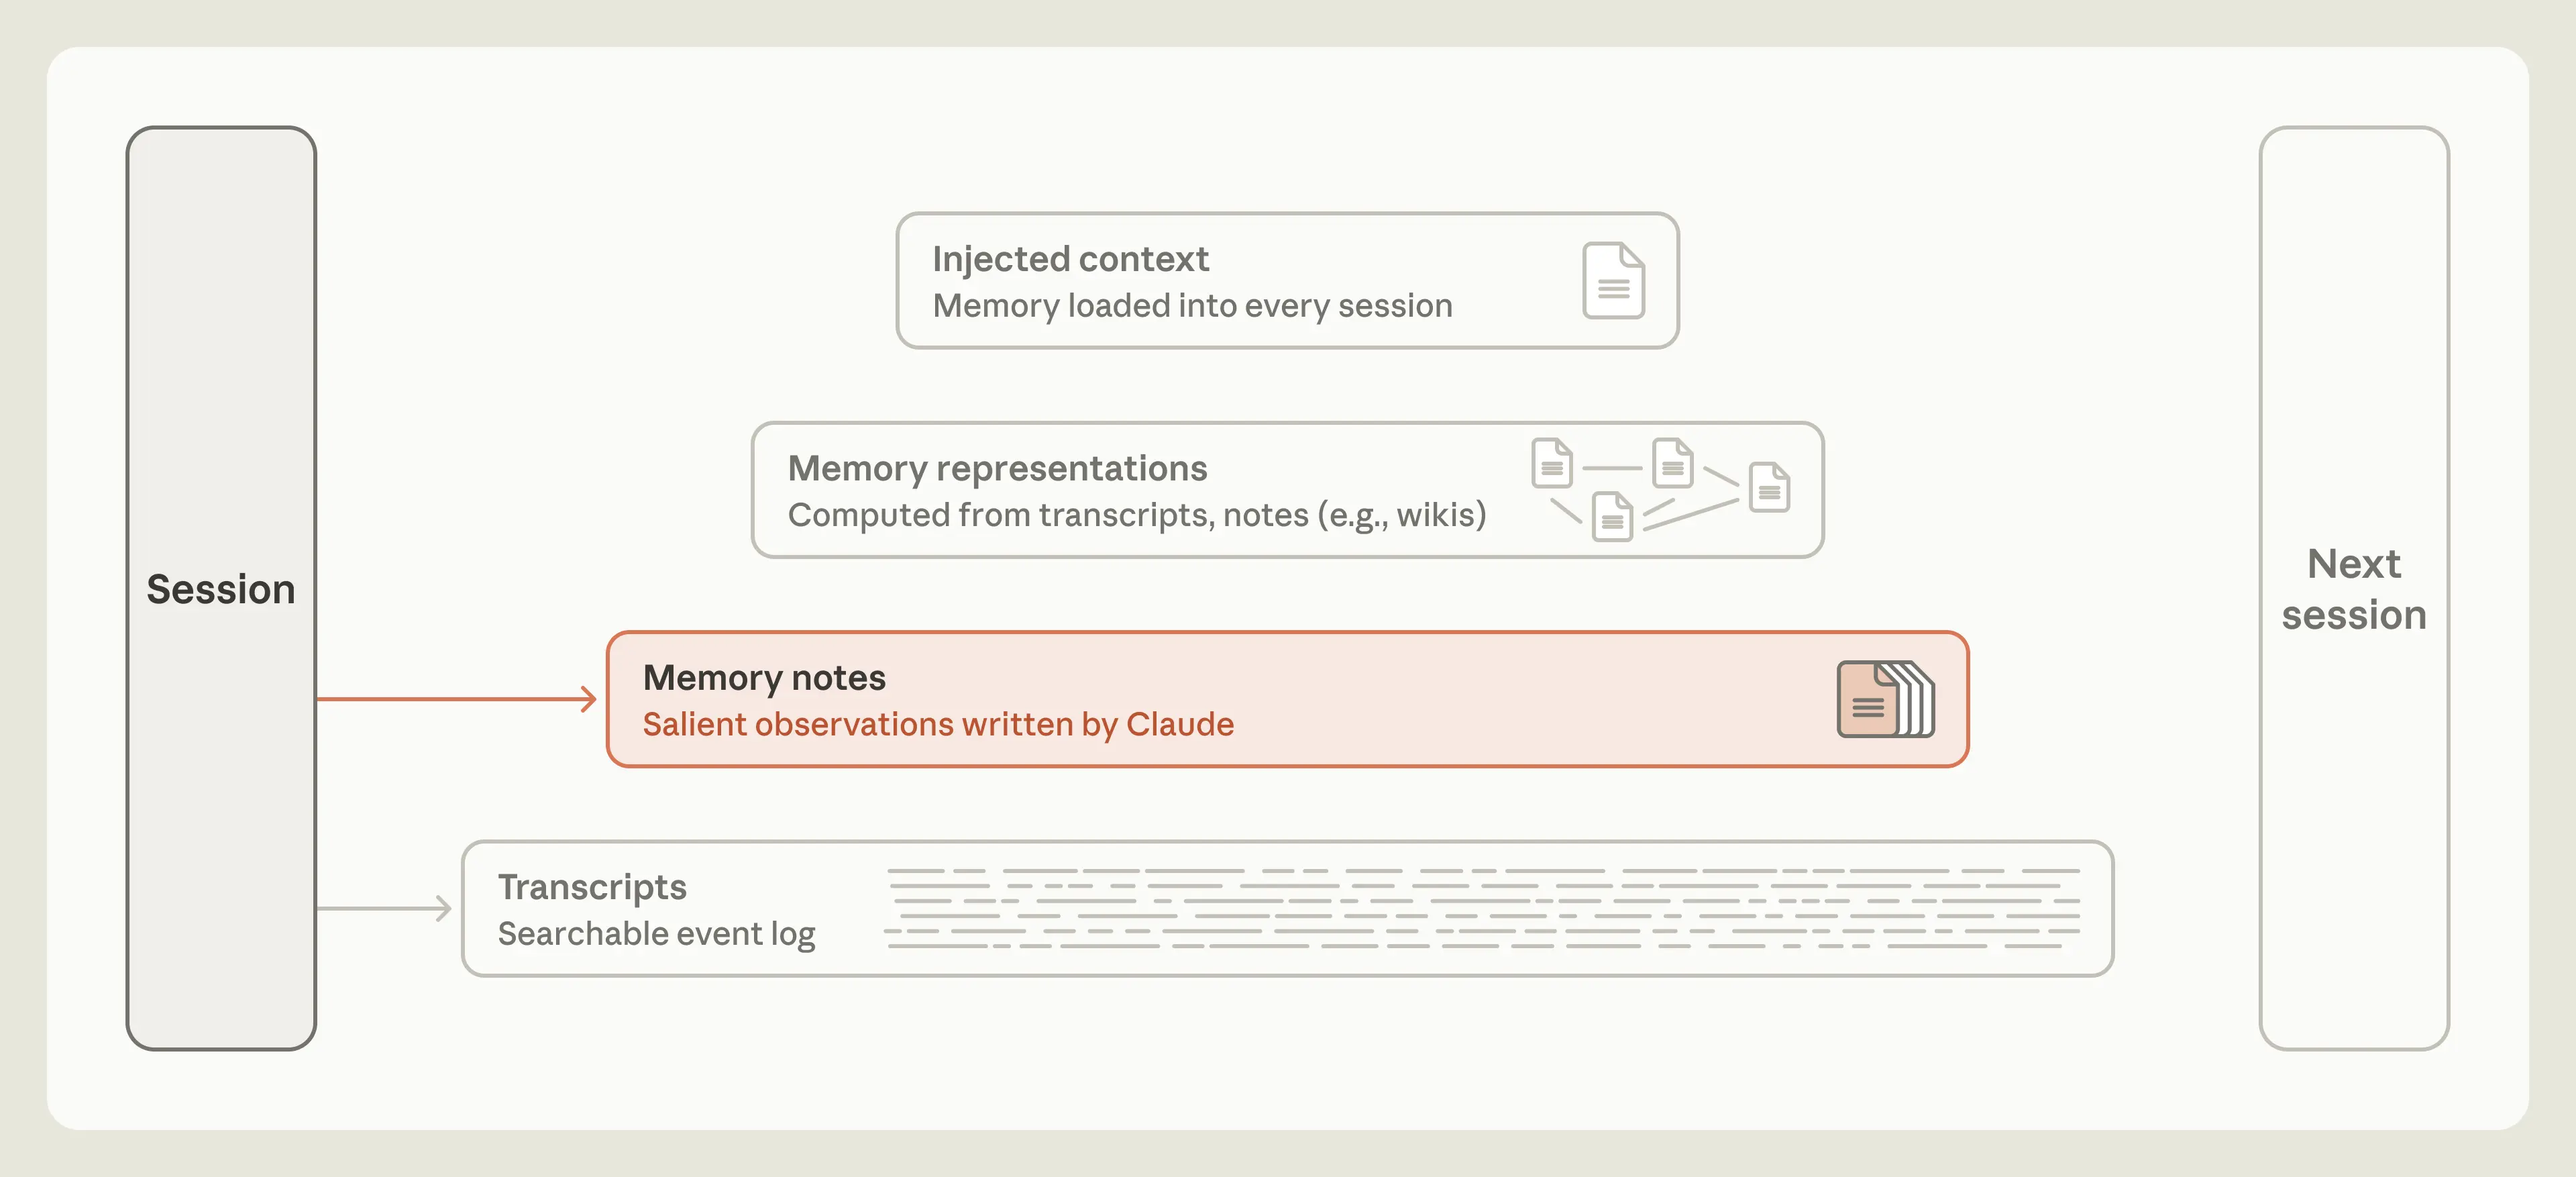
同样,Claude 可以在会话日志中标记重要事件,以便日后更容易找到它们,或者可以将它们写入记忆存储,例如记忆笔记文件夹(图 2)。但是,在知道接下来会发生什么之前,Claude 如何判断当下哪些事件是重要的呢?
记忆可以预测未来的需求
记忆有时是一种预测。通过记录规则,智能体预测它所描述的模式将来还会再次适用。例如,记录一个已验证的事实,就相当于预测智能体在未来的会话中会想要依赖这个事实,而无需再次核实。随着时间的推移, Claude 在做出这类预测方面变得越来越熟练。
考虑来自持续学习基准测试 (CL-Bench) 1.0的一个任务。CL-Bench 是一个基准测试,用于衡量智能体利用记忆处理长期任务的能力。其中一个特定任务要求 Claude 通过在数据库中查找信息来回答一系列问题。Claude 给出答案后,系统会告知它正确答案,并允许它写入记忆以帮助回答后续问题。
记忆在这里可以支持一个学习循环。如果 Claude 答错了题,它可以记录下这次失败,提出关于出错原因的理论,验证这些理论,并将发现的结果转化为未来如何作答的规则。
我们使用Claude Managed Agents运行了 CL-Bench 1.0 任务。Claude 在每个问题中都启动一个全新的会话,但有一个例外:它可以从一个会话延续到下一个会话的记忆目录中检索文件。
不同的模型在创建各自的学习循环方面取得了不同程度的成功。Claude Sonnet 4.6 甚至能够生成关于答案错误原因的理论。它的记忆目录中散布着许多文件,每个文件都列出了几个未经测试的猜测。
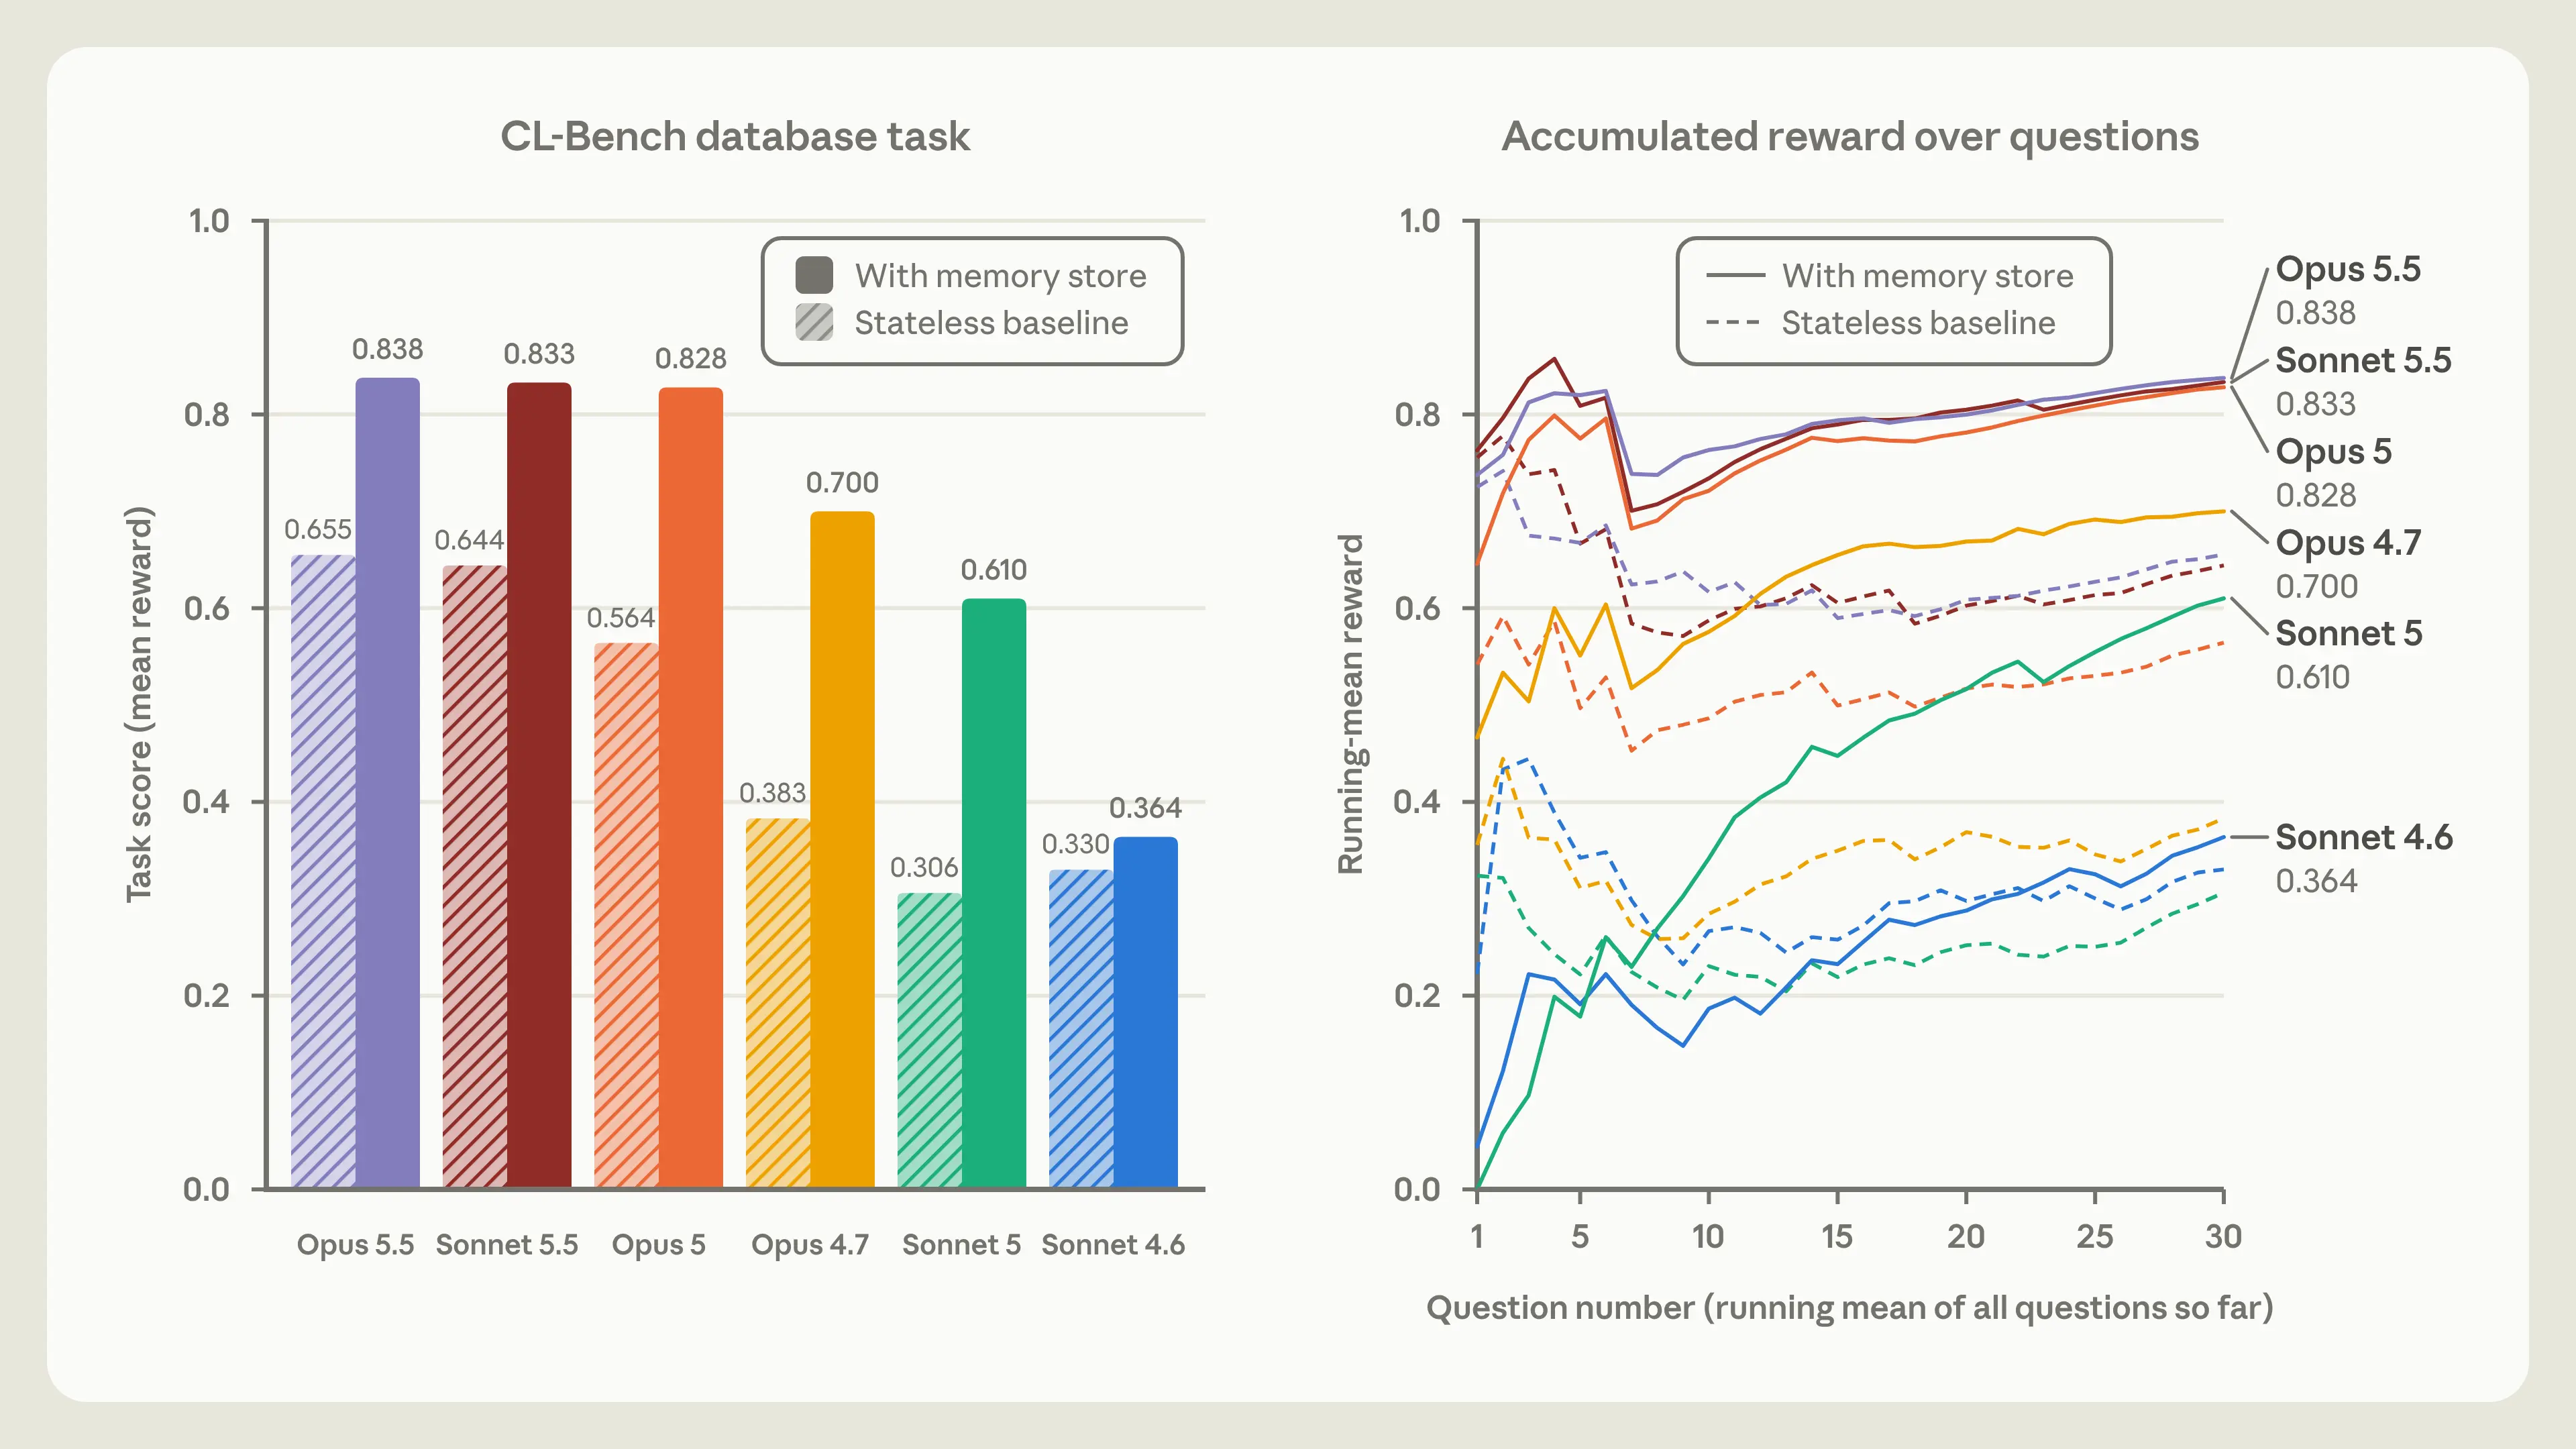
Claude Opus 4.7 将笔记整理成一份参考文档,并开始标记哪些事实已核实,哪些尚未确认。Claude Sonnet 5 在阅卷人核对后,将每个答案标记为已确认,并在答案错误时写出更正。
Claude Opus 5 是这些模型中第一个实现闭环的。它的大部分条目都包含一条规则(以及它如何知道这条规则是正确的)、对先前问题的回答,以及对它在此过程中发现的陷阱的明确警告(图 3)。
与 Opus 5 类似,Claude Opus 5.5 和 Claude Sonnet 5.5 也都实现了闭环,利用记忆来捕获已验证的规则,从而更好地回答未来的问题。有了记忆功能,它们的得分与 Opus 5 大致相同,尽管它们在没有记忆功能时的基线表现略高。
Claude 学会了判断显著性
我们还评估了 Claude 玩《精灵宝可梦 红》的能力。这款游戏旨在考验 Claude 处理复杂长时程任务的能力,以此测试 Claude 对需要保存哪些信息进行判断的能力。在每次运行开始时,我们为每个模型提供一个包含记忆文件的文件夹,供其在游戏过程中进行读写操作(图 4)。
我们比较了 Claude Sonnet 3.7 和 Claude Fable 5 各自运行一次后,在游戏进行约 10,000 步时生成的记忆文件夹。我们注意到一个关键区别在于每个模型认为哪些信息值得记住。Sonnet 3.7 认为所有信息都可能重要,因此会不加区分地写入记忆。它的记忆文件夹包含一个遭遇记录存档,通常每个战斗、每个物品和每个遇到的非玩家角色都会单独创建一个文件。最终,Sonnet 3.7 在 225 个文件夹中写入了 413 个记忆文件,并获得了一枚徽章(徽章用于标记玩家的游戏进度)。
相比之下,Fable 5 在两个文件夹中编写了九个文件,外加一个名为 global.md 的顶级文件,并获得了四个徽章。
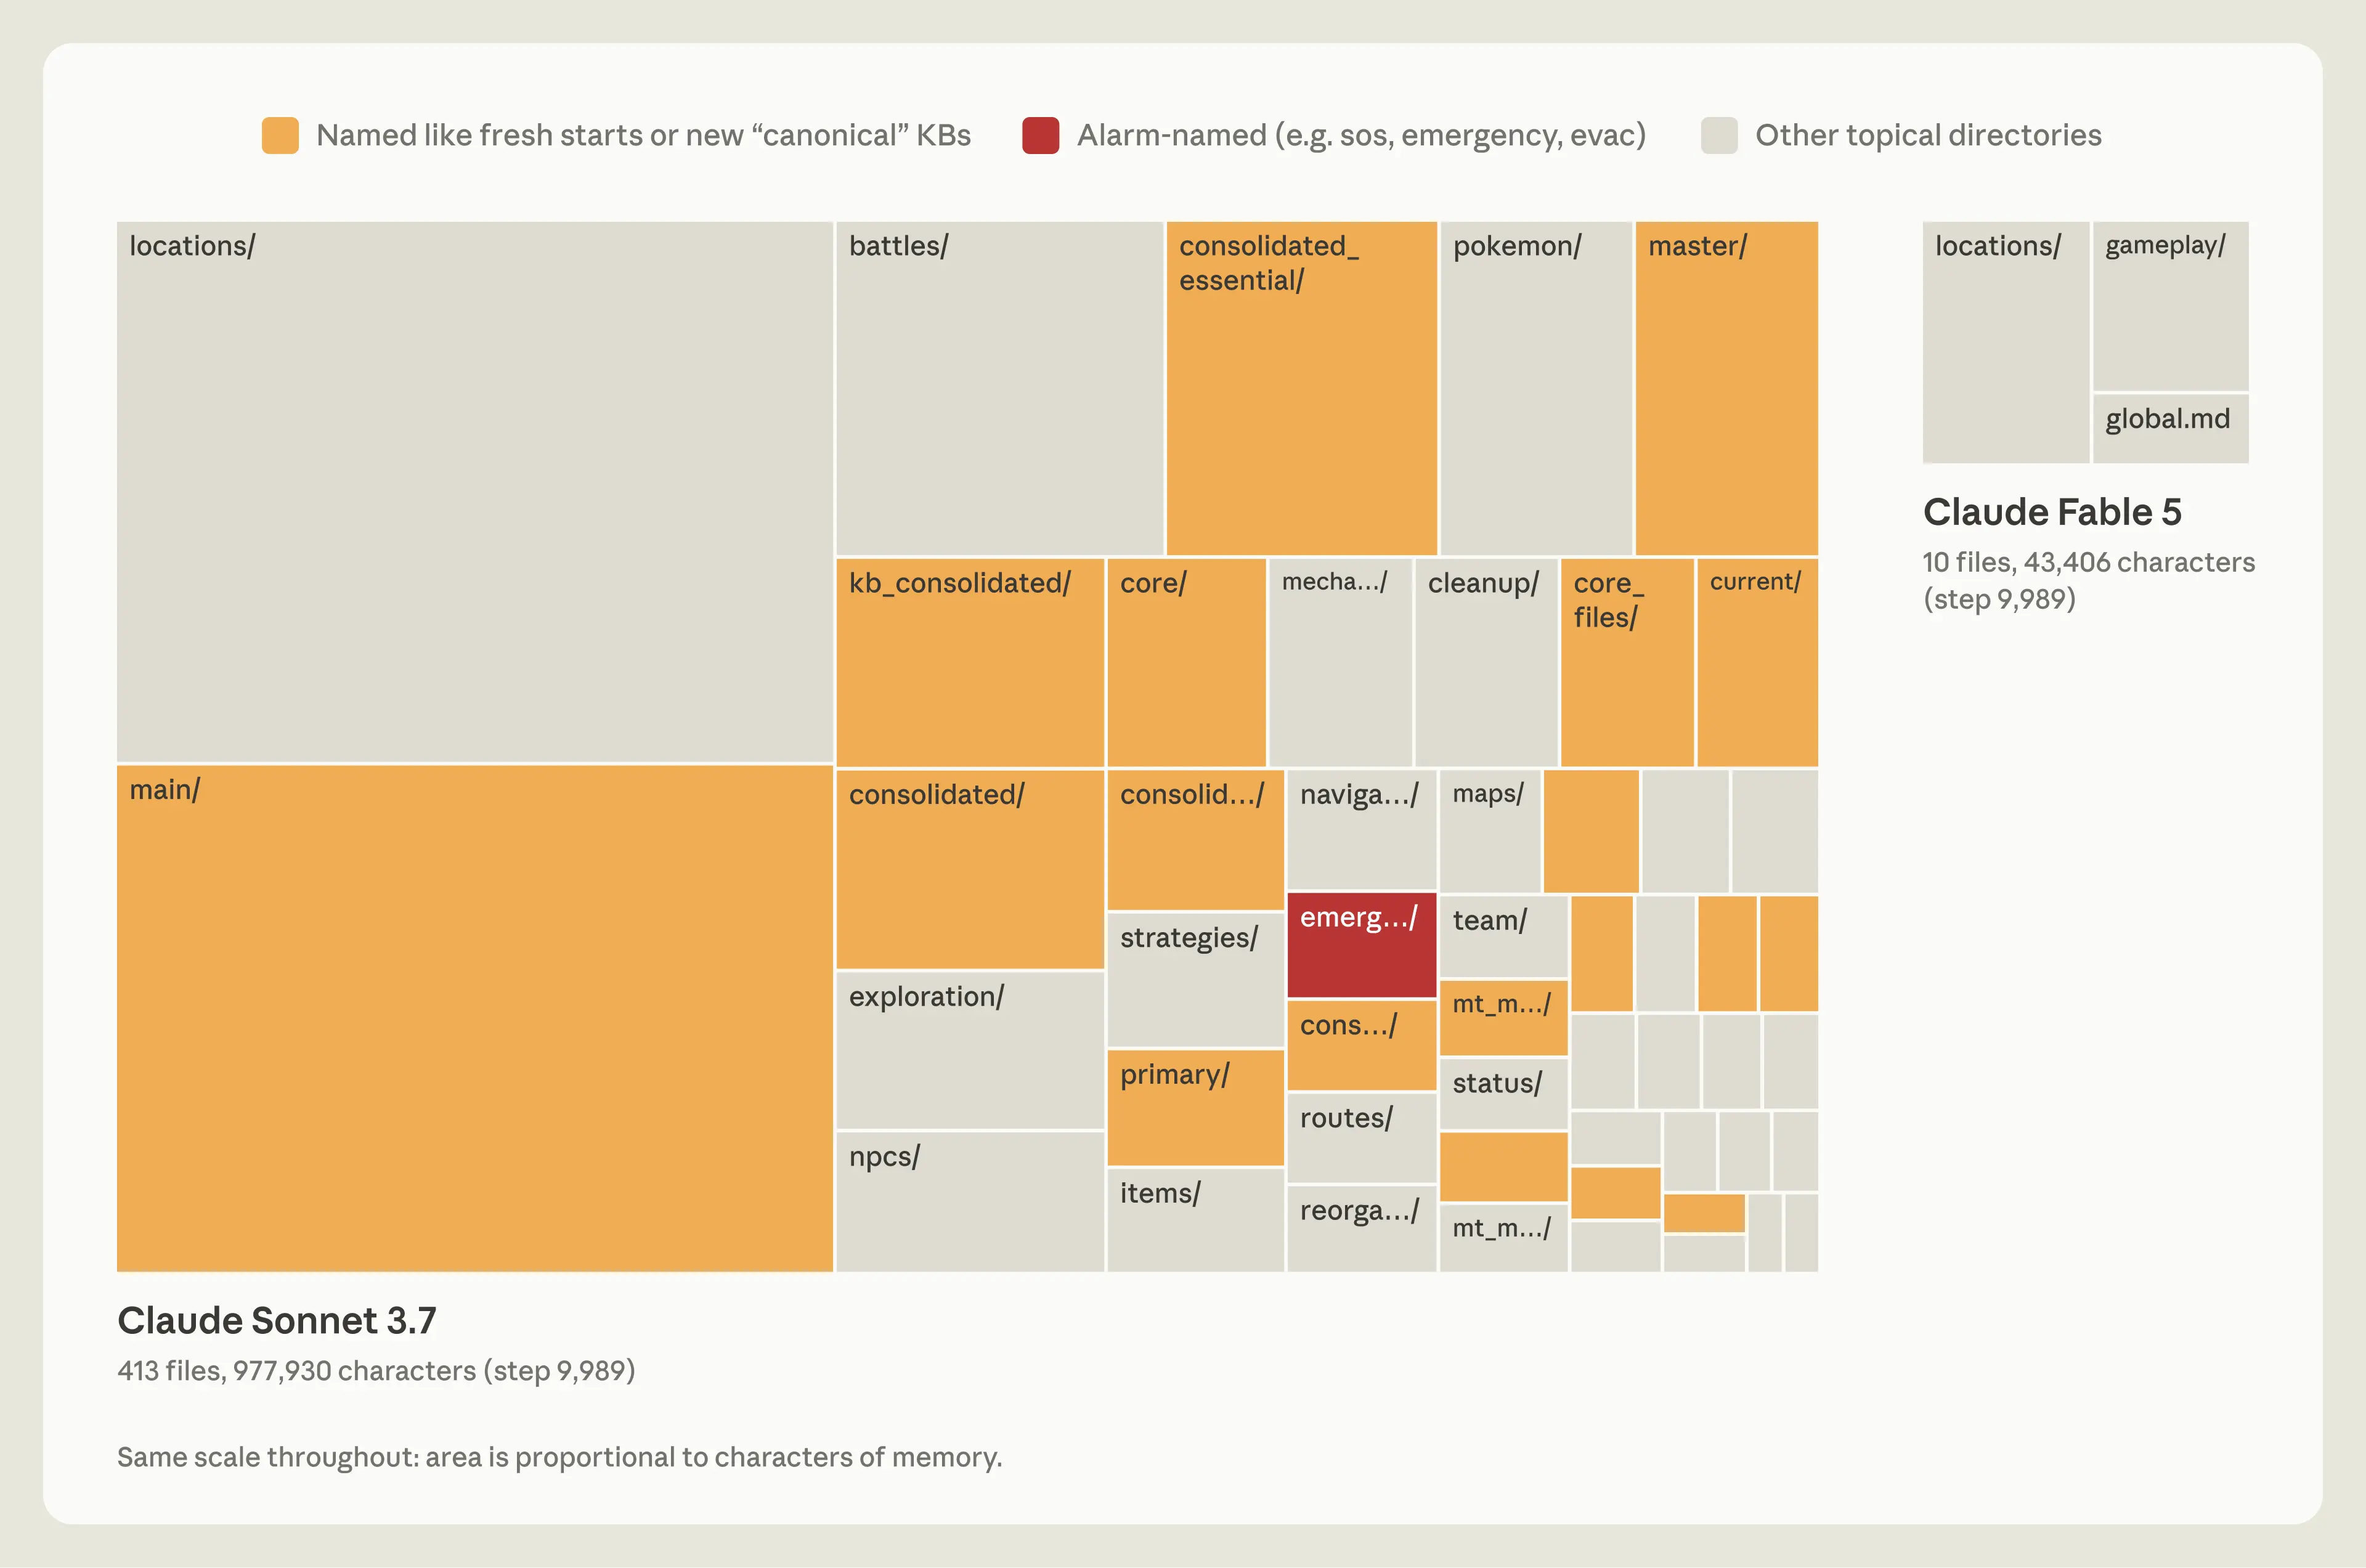
Sonnet 3.7 的方法存在主要问题,因为宝可梦的游戏状态不断变化——Sonnet 3.7 的详细记录会持续过时。因此,随着 Claude 的推进,它不得不花费更多的时间和资源来梳理记忆,而不是进行游戏。例如,大约在第 10000 步时,Sonnet 3.7 开始创建第四个“主”记忆文件文件夹。在接下来的 17 步中,它创建了 6 个文件,删除了 9 个文件,而没有在游戏本身中进行任何操作。
Fable 5 的实现方式是利用记忆来处理游戏中没有明确告知的信息。例如,Sonnet 3.7 中一些需要写入记忆的信息——比如玩家拥有的金钱数量或玩家在地图上的位置——每回合都可以从屏幕上读取,因此存储这些信息是多余的。相比之下,关于策略、计划和已验证规则的记忆文件只有在 Claude 制定出来后才会存在,而且除非 Claude 将其记录下来,否则它们就会消失。
Fable 5 相应地组织了它的记忆。它的 global.md 文件就像一个仪表盘,保存着当前目标、预先编写的道馆挑战计划(挑战可以获得徽章),以及模型自身使用记忆的规则。一个 locations 文件夹存放着特定路线的导航计划,另一个 gameplay 文件夹则存放着基于游戏机制的策略。例如,在连续投掷七个精灵球都未能捕捉到鲤鱼王(最容易捕捉的宝可梦之一)之后, Claude 写道:“如果连续投掷三个或更多精灵球失败,就改变投掷时机(在菜单步骤之间插入额外的‘等待’按钮)——这样做之后,就成功捕捉到了。”
由于记忆文件夹小得多,Fable 5 的游戏进度比 Sonnet 3.7 要快得多。Opus 5.5 采用了类似的方法:它保留了一个用于记录当前目标和下一步行动的小型记忆笔记文件夹,并在游戏过程中不断重写这些笔记,最终通关。
引导 Claude 去写记忆
我们发现,告诉 Claude 记忆的用途很有帮助,但无需告诉它如何使用。在 CL-Bench 测试中,我们只是告诉 Claude 有一个记忆文件夹可用。这种通用指导足以让 Opus 4.7 和 Opus 5 有效地使用记忆,并且都显著提升了性能(图 3)。
我们还测试了为模型设定关于记忆写入内容的具体规则,每次测试使用一条规则。我们比较了每个模型在每条规则下从记忆中获益的程度,以及在不使用该规则的情况下获益的程度。当我们设置一条“仅记录失败”的规则时,Opus 5 和 Opus 4.7 的性能提升都大幅下降(图 5,右)。对于更强大的模型,赋予它们判断显著性的自由比预先设定固定规则更有效,而且这些规则最终可能会降低模型的性能。
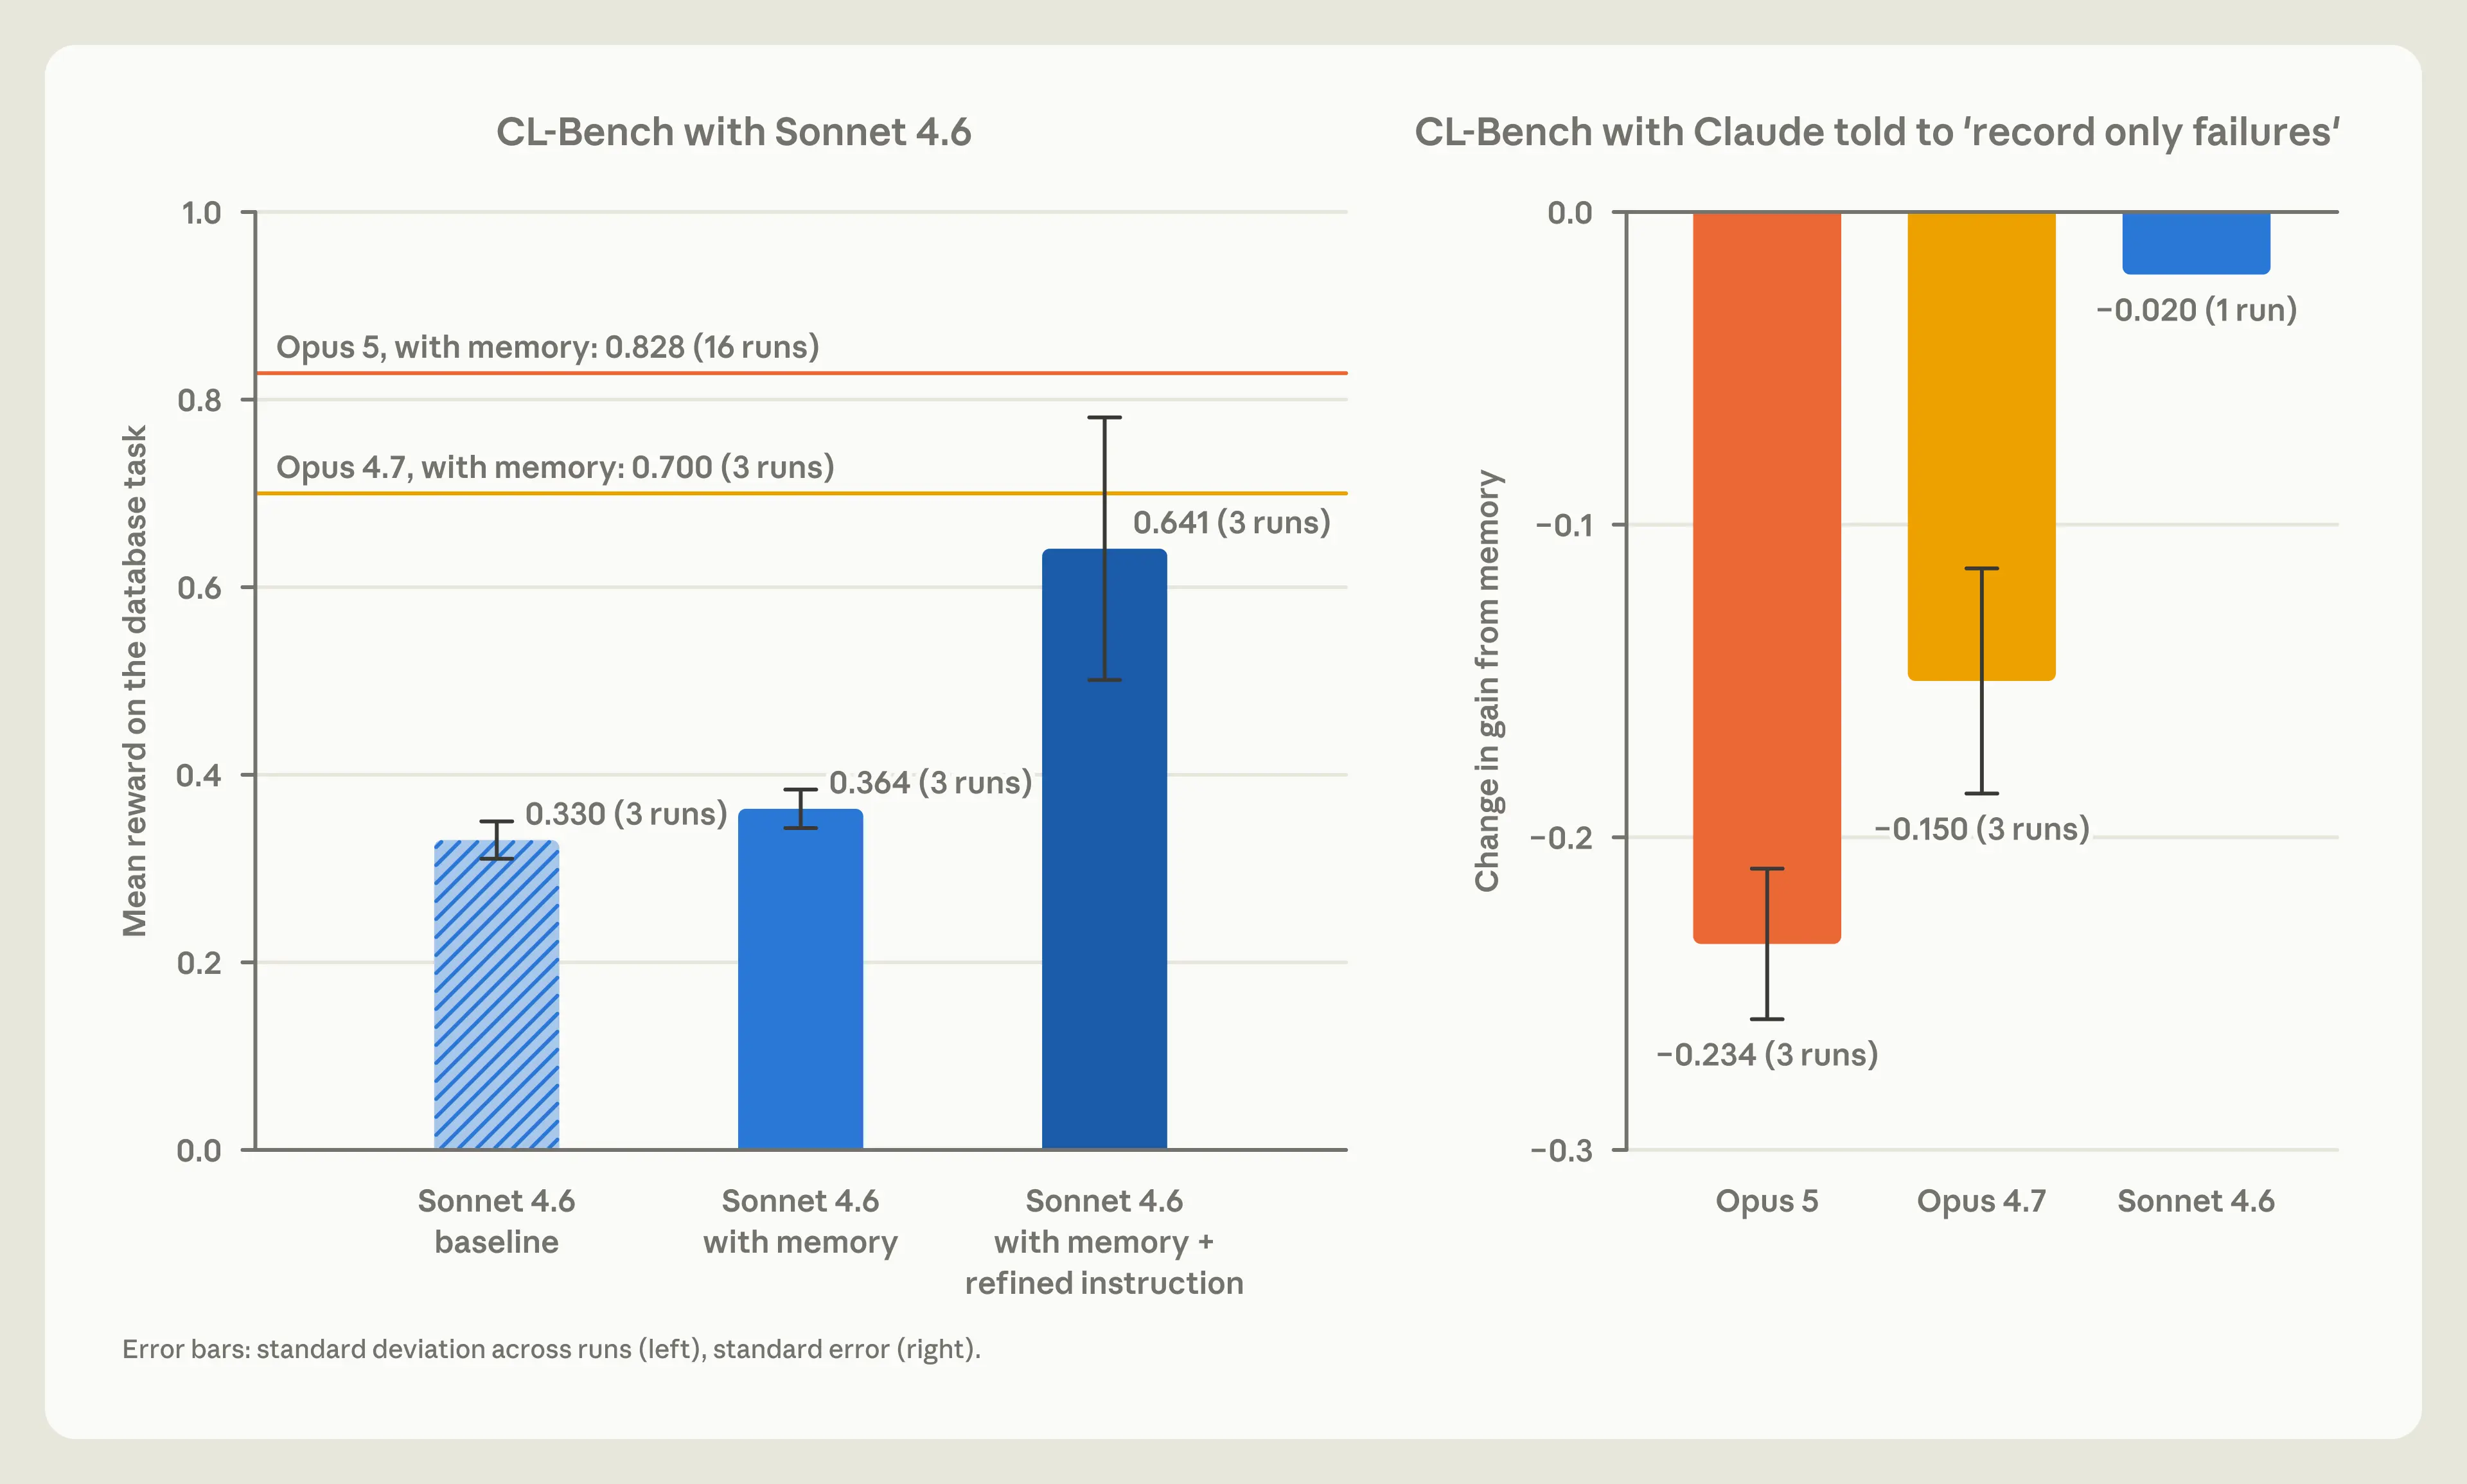
右图:当模型被要求仅记录失败数据时,其记忆使用效率的变化情况。
我们还注意到,转向功能对老款模型的帮助最大。例如,Sonnet 4.6 经常无法读取记忆目录中的文件,也无法验证其关于答案错误原因的理论。
在这种情况下,提示 Claude 在回答问题前读取其记忆文件,并明确地验证其理论,使其基准得分几乎翻了一番(图 5,左)。Sonnet 5 会自动执行此操作。无需提示,它在 10 次回答中就有 9 次会在回答前读取记忆文件。相比之下,Sonnet 4.6 执行此操作的概率不到一半。
对于前沿的Claude模型,我们通常会提供简单的指导,以便在有人要求或某些事情明显值得记住时创建记忆笔记,而我们将这种判断留给Claude。
做梦可以纠正记忆
由于 Claude 会根据它在会话中判断出的重要内容来记录记忆,因此,即使笔记从一开始就是错误的,或者随着环境的变化而有所偏差,Claude 仍然可以在以后的会话中阅读并相信它。
梦境让Claude能够将自己的笔记与原始记录进行比对(图 6)。我们看到了一个积极的例子:Claude使用托管智能体玩宝可梦游戏时,其记忆目录已被挂载。
在游戏的某个环节,玩家必须穿过月见山,这是一个洞穴系统,入口在地图西侧,出口在东侧。入口附近有一个陷阱:一个单向的悬崖,玩家一旦掉下去就会回到来时的路上,而且没有明显的返回路径。Claude以位于山口的宝可梦中心为地标,所以它是否会掉下悬崖取决于它认为宝可梦中心在山的哪一侧。
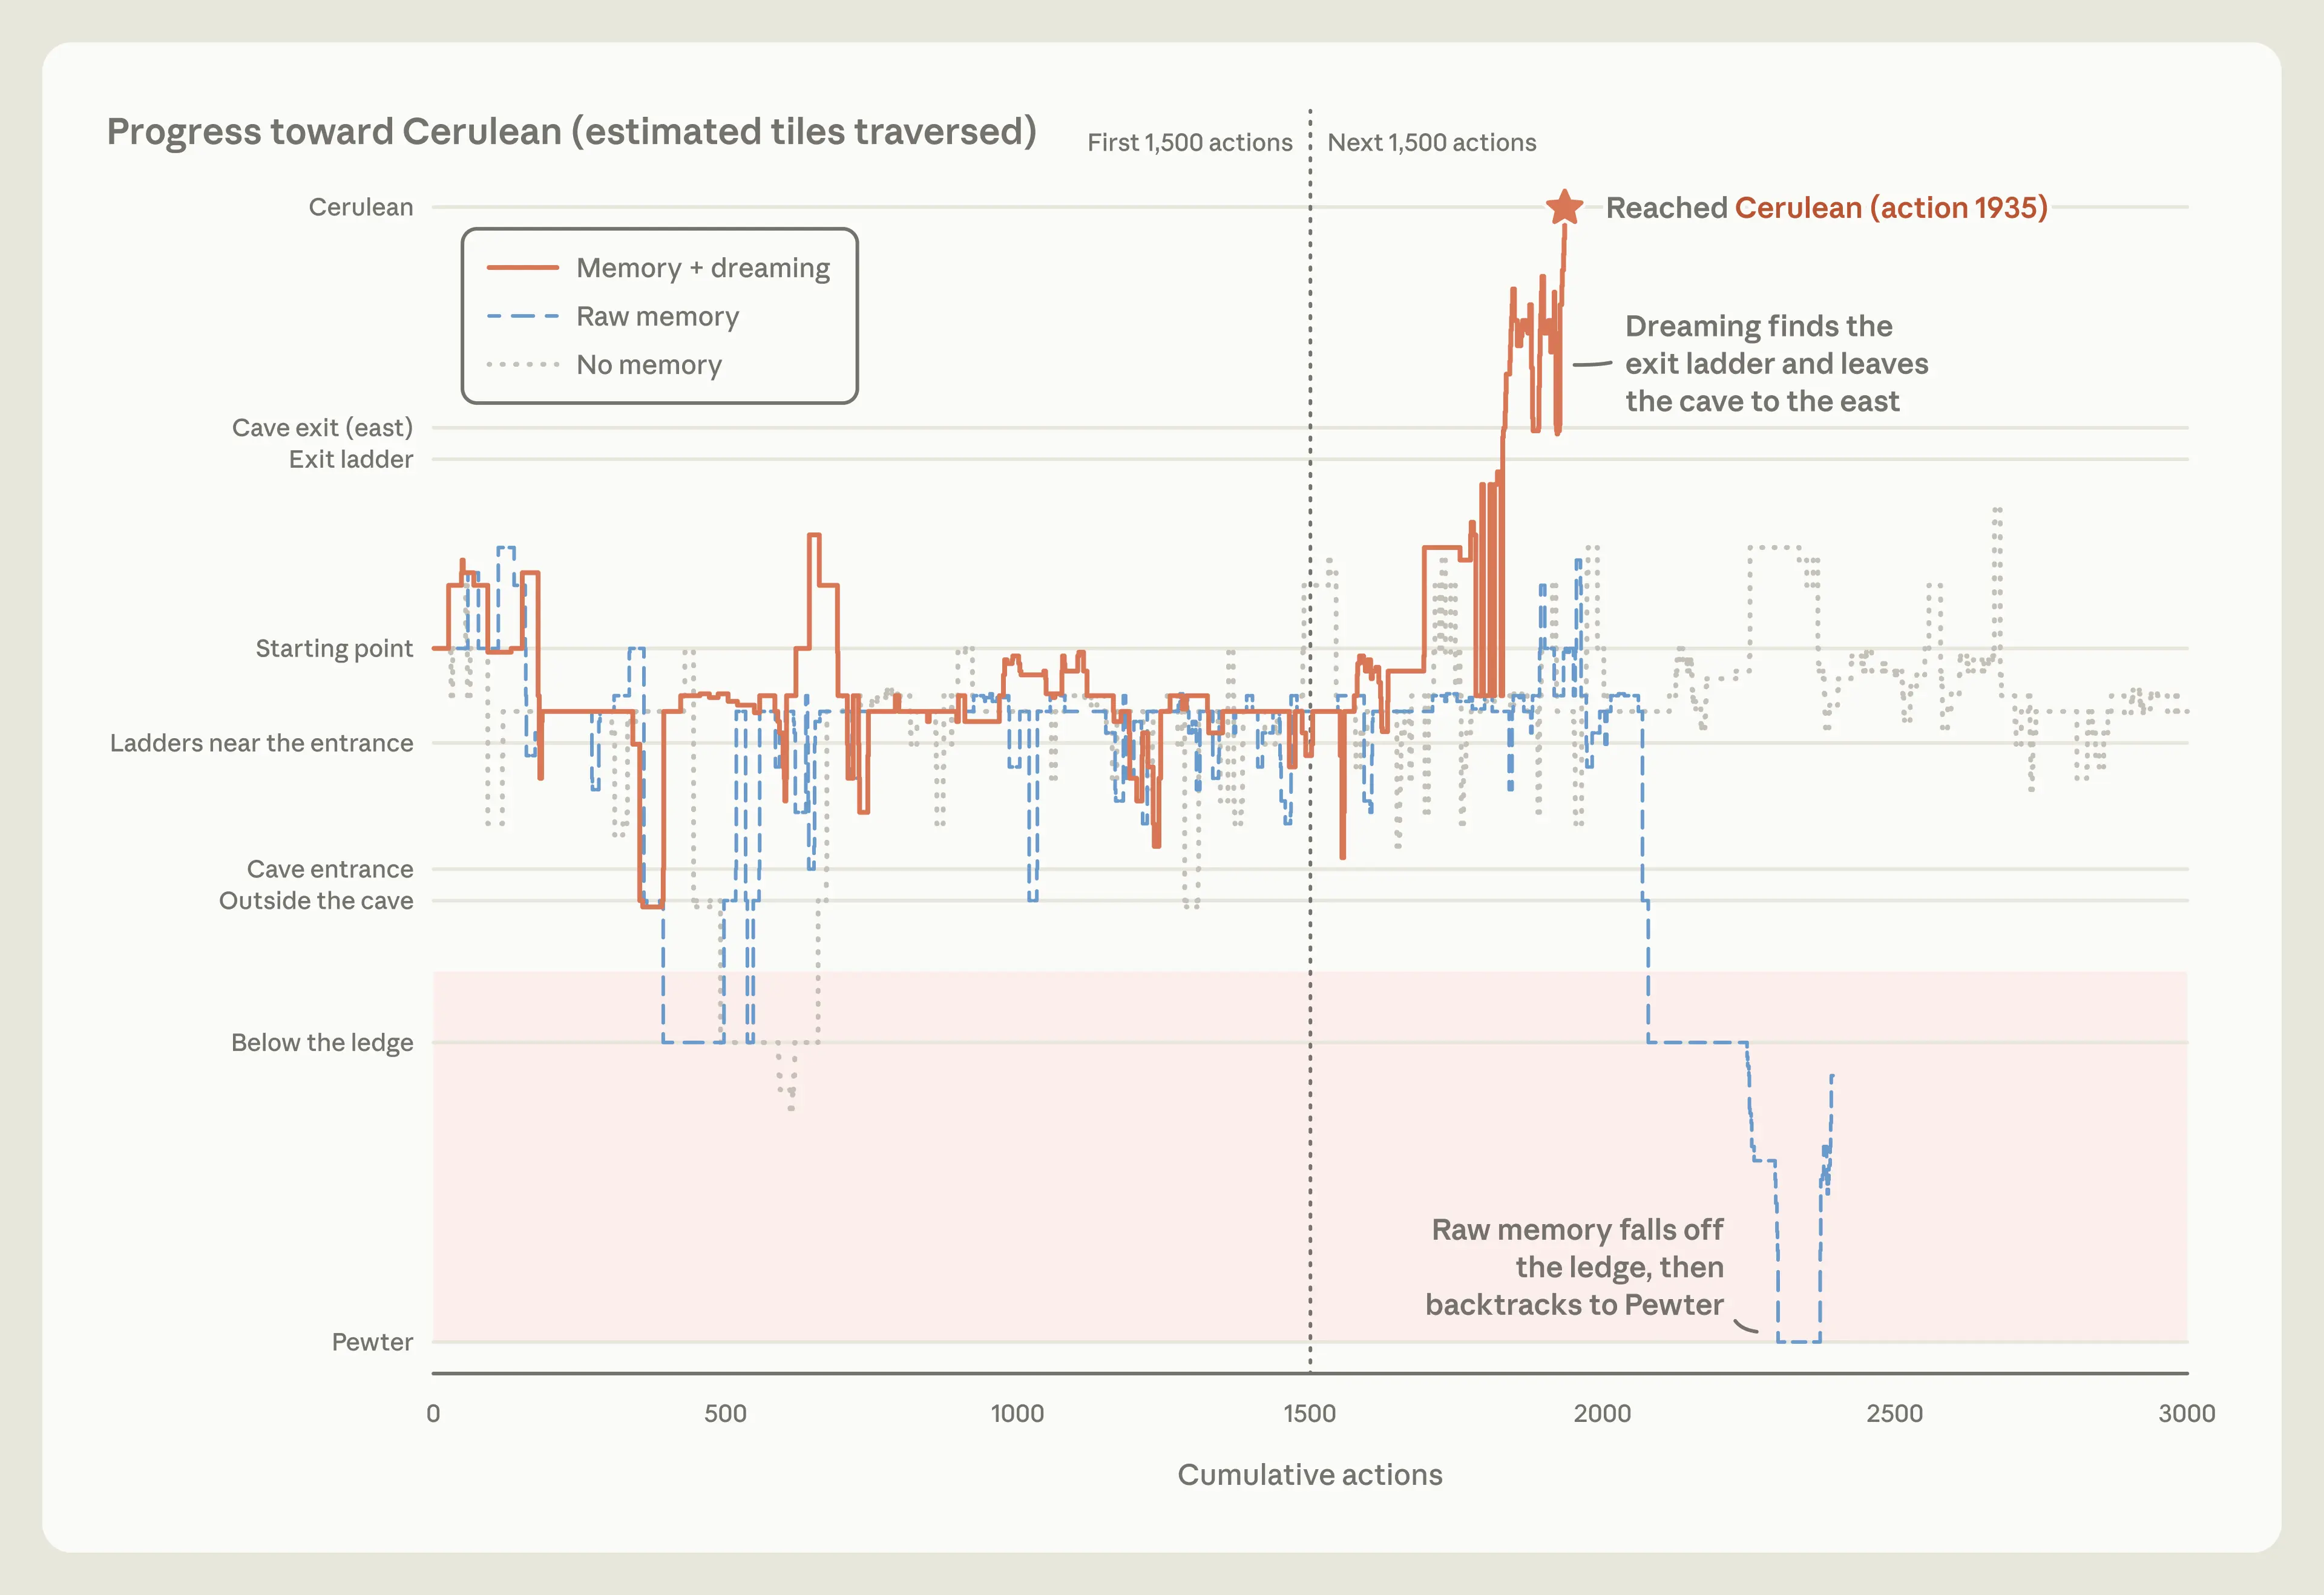
Claude一度错误地记录下宝可梦中心在东侧。当他走出宝可梦中心时,他宣布“月见山在我身后”,并更新了笔记:“月见山已完成”。但月见山并不在他身后。几步之后,Claude翻过悬崖,落回了来时的路上(图7)。导航工具没有显示这次坠落,于是Claude得出结论:“我走得太偏西了”,并认为自己一直都在正确的一侧。然而事实并非如此。
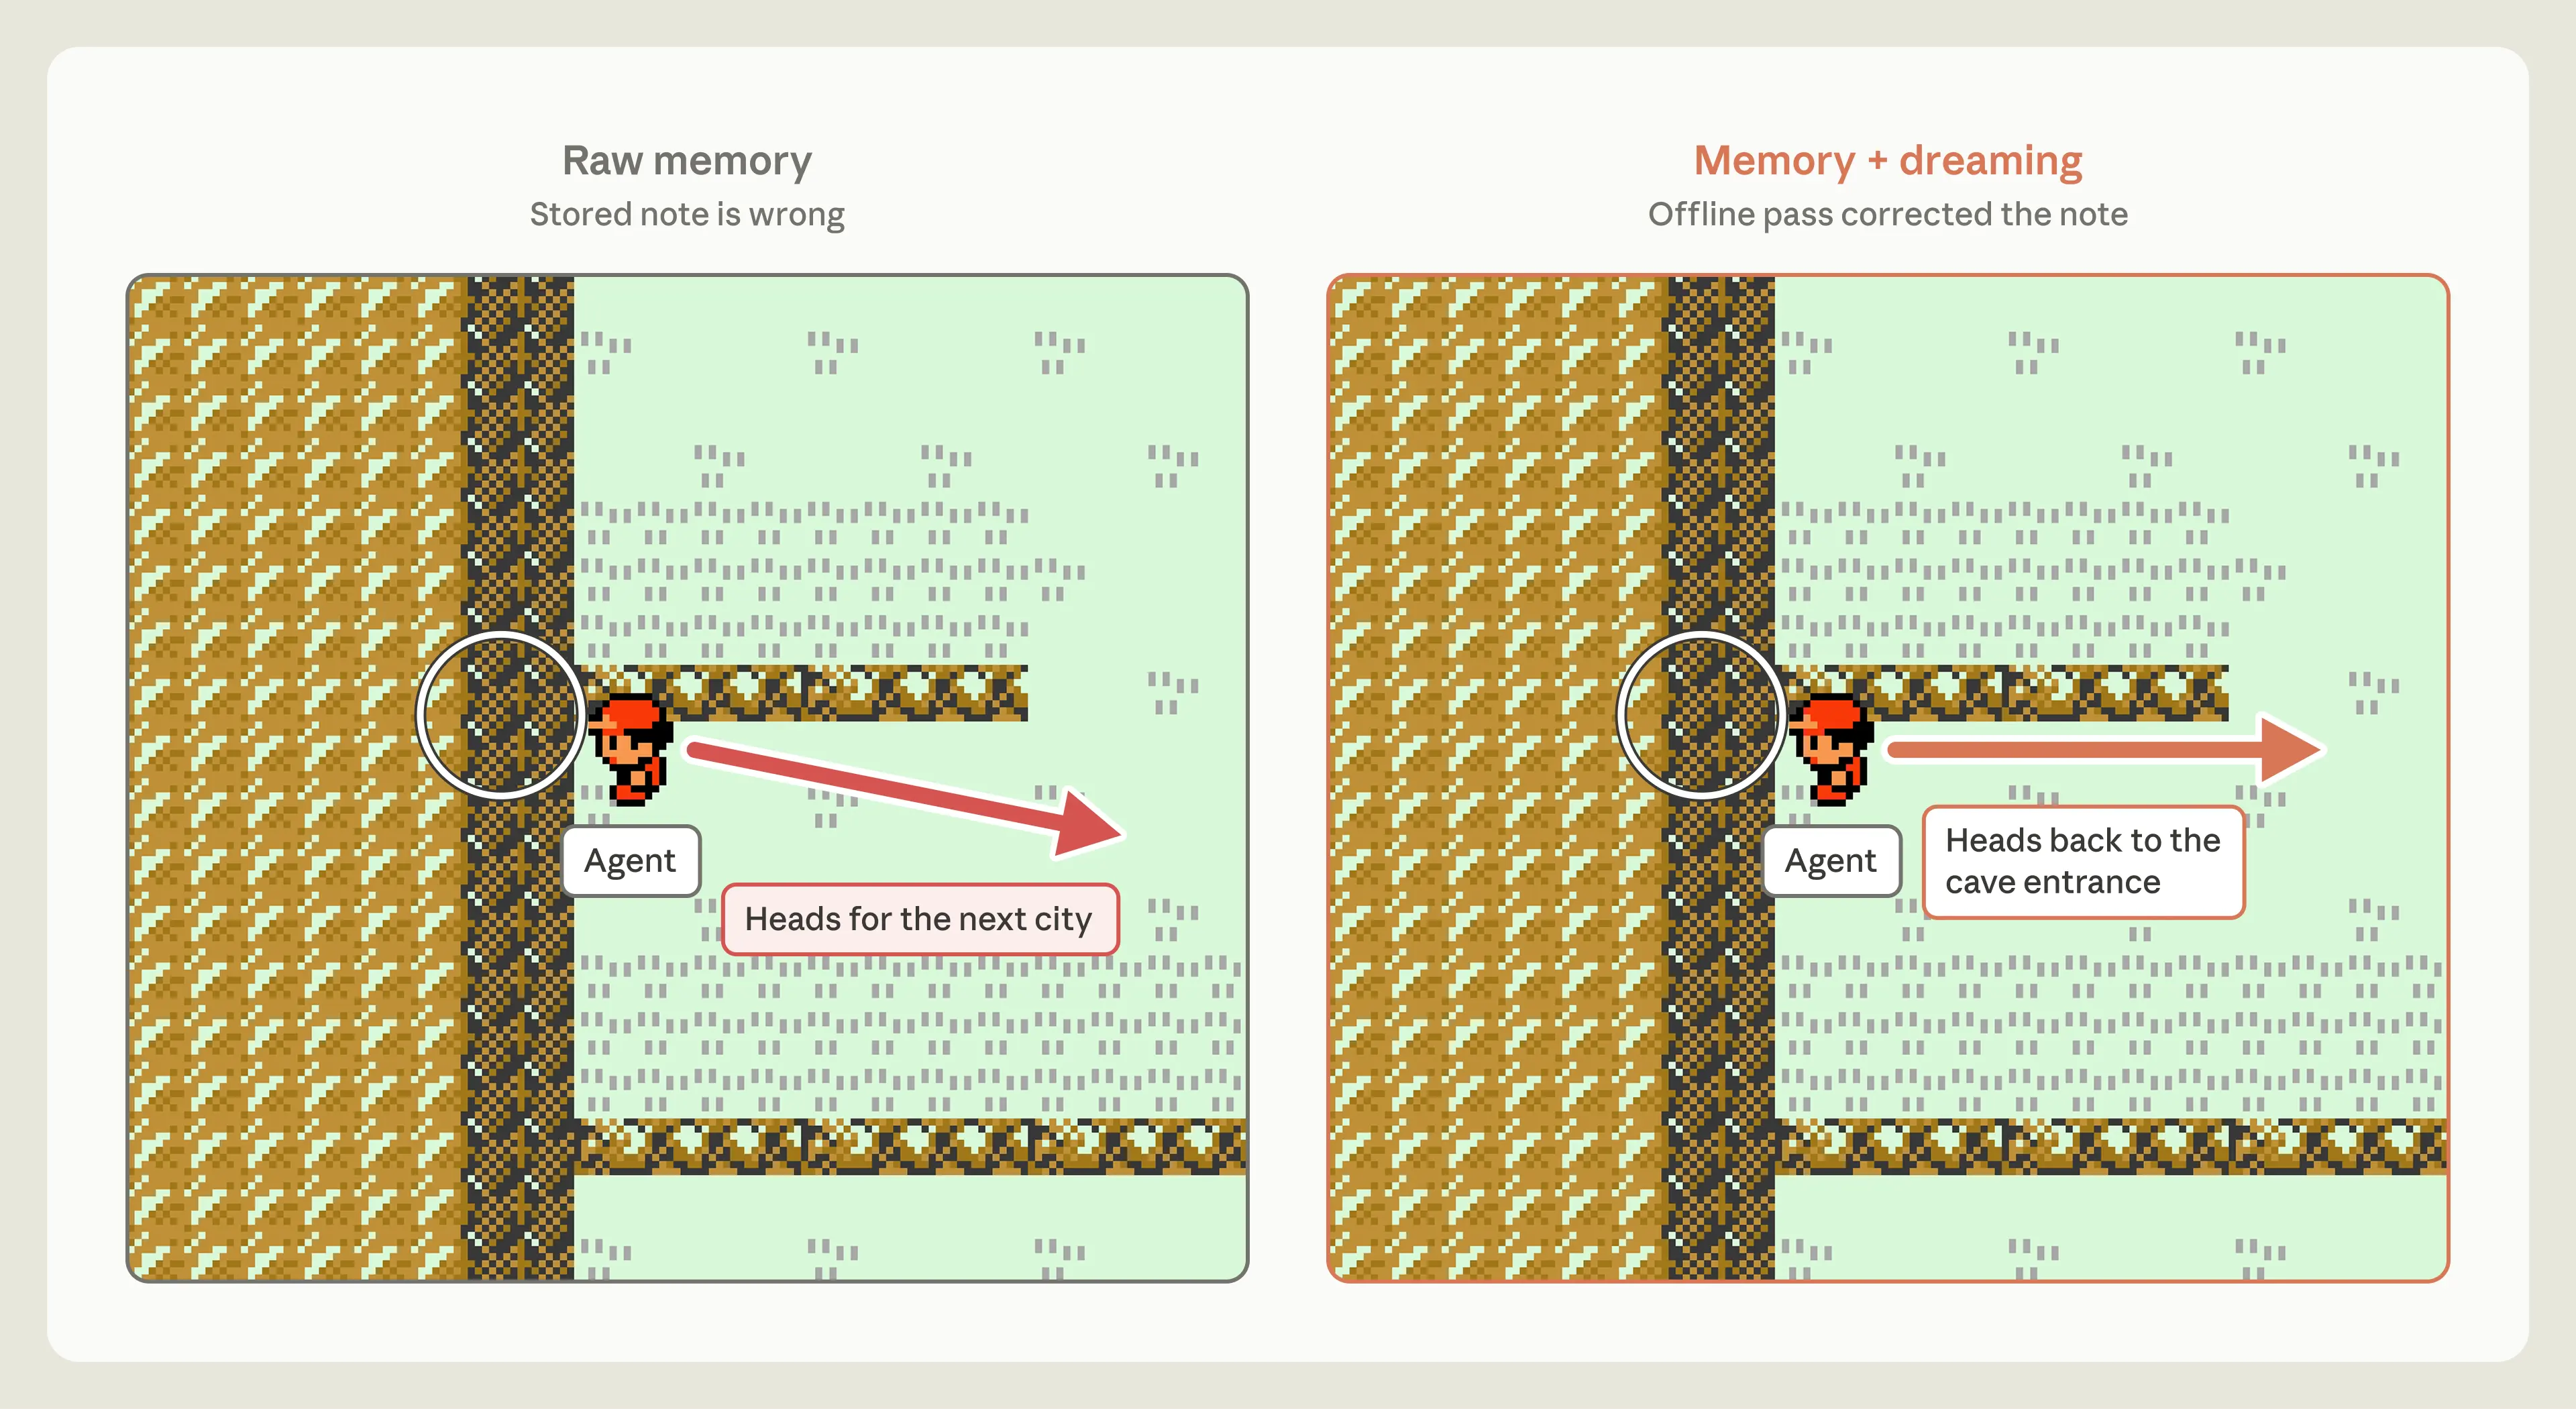
我们随后测试了梦境能否帮助Claude避开这个陷阱。我们对包含错误宝可梦中心位置的记忆文件夹进行了梦境测试:Claude将笔记与游戏记录进行比对,发现了错误并进行了修正。游戏记录为Claude提供了一个可以用来验证记忆的基准。有了修正后的记忆笔记,Claude直接返回了月见山,最终到达了华蓝市。
在这次未修正错误提示的运行中,Claude三次返回到之前的路线。第三次失败后,Claude似乎放弃了,写道:“我不想再循环了,还是停下来吧。”我们设置的自动回复指示它继续。于是它继续运行,一路返回到山脉前的城镇——白银城,希望在那里恢复体力并补充物资。最终,Claude未能到达蔚蓝城,这次运行就此结束。
做梦可以构建新的记忆表征
通过做梦,Claude可以构建记忆表征来帮助他梳理记忆(图 9)。他使用的一种记忆表征被称为“维基”,它是由Claude编写和维护的一系列页面,收集了Claude对某个主题的了解,并将其与其他笔记链接起来。这些链接实际上为Claude提供了一张地图,他可以利用这张地图筛选记忆,并在需要时高效地找到相关记忆。
类似维基这样的表示形式可以帮助 Claude 浏览其不断增长的知识库。我们使用来自 Stainless(一家我们于五月份收购的软件公司)的内部文档语料库(约 35 万个文件,约 4.2 亿个词元)来探索维基作为记忆表示的优势。我们创建了一个包含 25 个问题的评估集,用于评估该语料库,并为 Claude 提供了一个搜索工具来探索它。我们还指示 Claude 使用“梦境”功能基于这些文件构建一个维基。在 128 个会话中,我们引导 Opus 5 智能体探索文件、编写或更正链接的维基页面、合并重复项,并核对信息来源。
每次实验都建立在之前实验中取得的进展之上,并使用共享日志来协调工作。随着实验次数从两次增加到 128 次,25 个问题的评分标准完成率也从 13% 提高到 48%(图 10)。
Claude 逐步构建其维基。创建初始维基后,它会通过后续的梦境轮次来添加、编辑或精简内容。在梦境的早期阶段,Claude 的知识水平如同新员工,仅凭维基回答问题的能力有限。随着梦境的增多,其知识图谱也日渐丰富,如同经验丰富的员工。在我们的测试中,我们发现,当 Claude 同时拥有搜索工具时,维基对其帮助最大。当 Claude 同时使用搜索和维基时,随着维基的不断完善,其综合得分从 54% 提升至 61%,而仅使用搜索工具时,得分仅为 53%。Claude 仅使用维基回答问题时,最高得分为 48%。此外,同时使用搜索和维基还能为每个问题节省约 20,000 个词元。
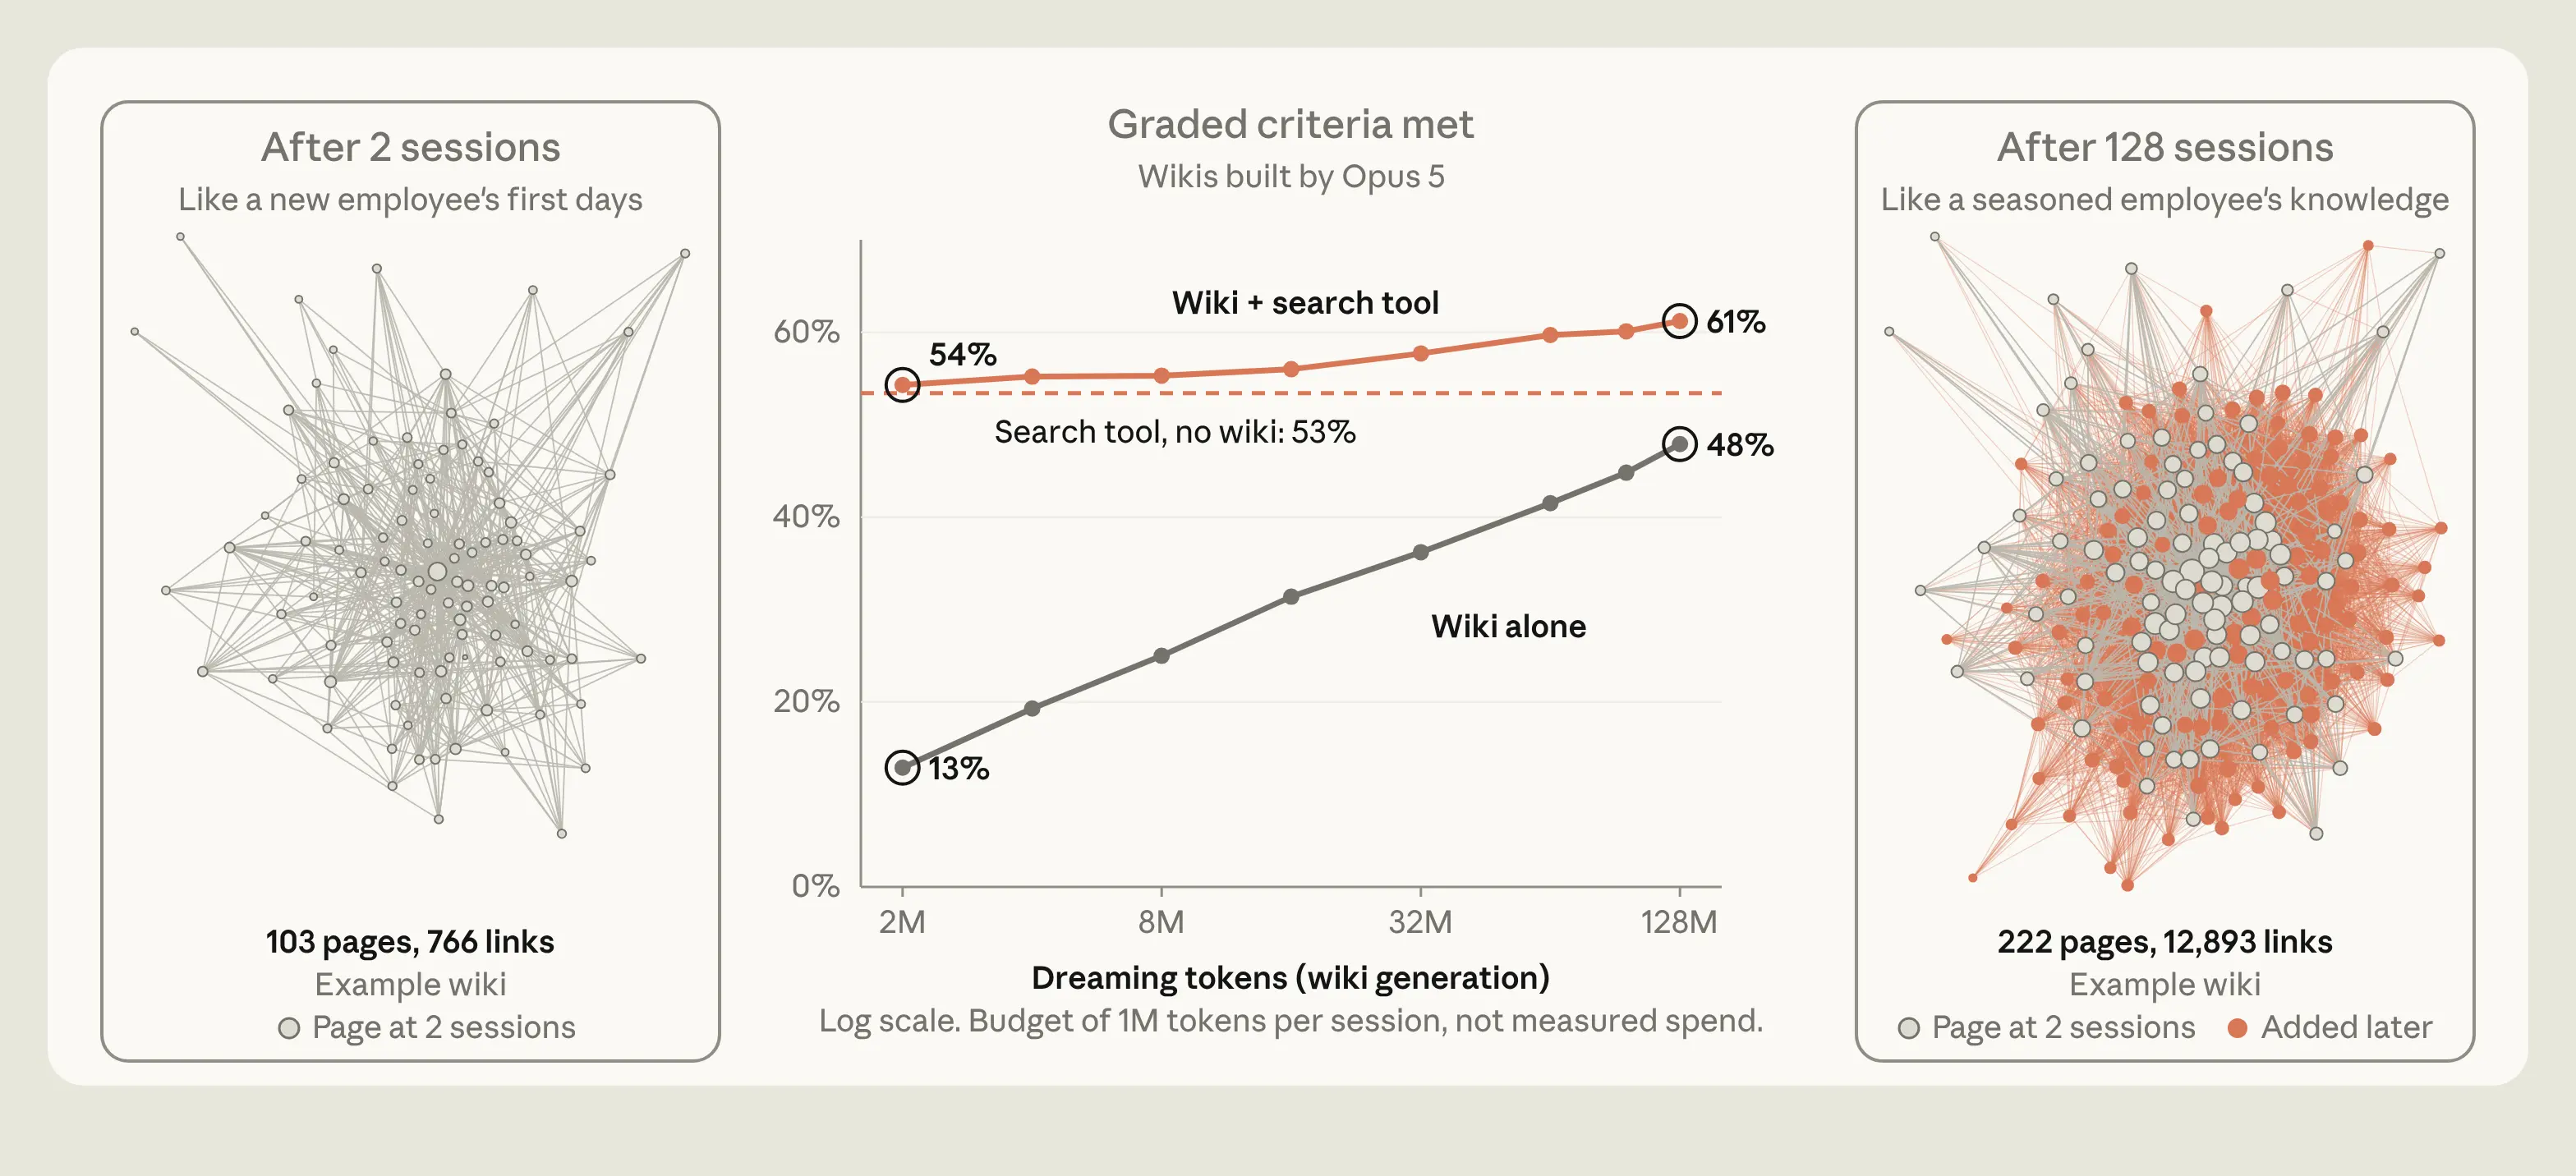
左侧和右侧:分别展示了经过两次和128次会话后的示例维基;每个点代表一个页面,线条连接链接的页面。
我们想测试哪些类型的任务能从 Claude 的 wiki 中受益。为此,我们使用了Harvey LAB基准测试以及一系列关于合并的文档。该基准测试会给 Claude 提供一组文档,并要求他根据这些文档的内容生成一份法律摘要。然后,基准测试会根据一系列标准对摘要进行评分。虽然这可能不如玩宝可梦跑酷那么有趣,但这些评估为我们提供了可用于构建 wiki 的各种文档集合。
我们指示 Claude 根据文档创建一个维基页面。然后,我们要求 Claude 回答问题(关于合并事宜)或生成法律摘要(LAB 基准测试),测试方法包括直接搜索维基页面和直接搜索文件。其中一项测试包含 24 个关于合并事宜的问题(图 11,左),超过一半的问题需要 Claude 在多个文档中查找信息,许多问题还需要 Claude 运用判断力或进行计算。对于这些问题(红色和橙色线条所示),Claude 在查阅维基页面时得分为 87%,而仅使用搜索功能时得分为 73%。
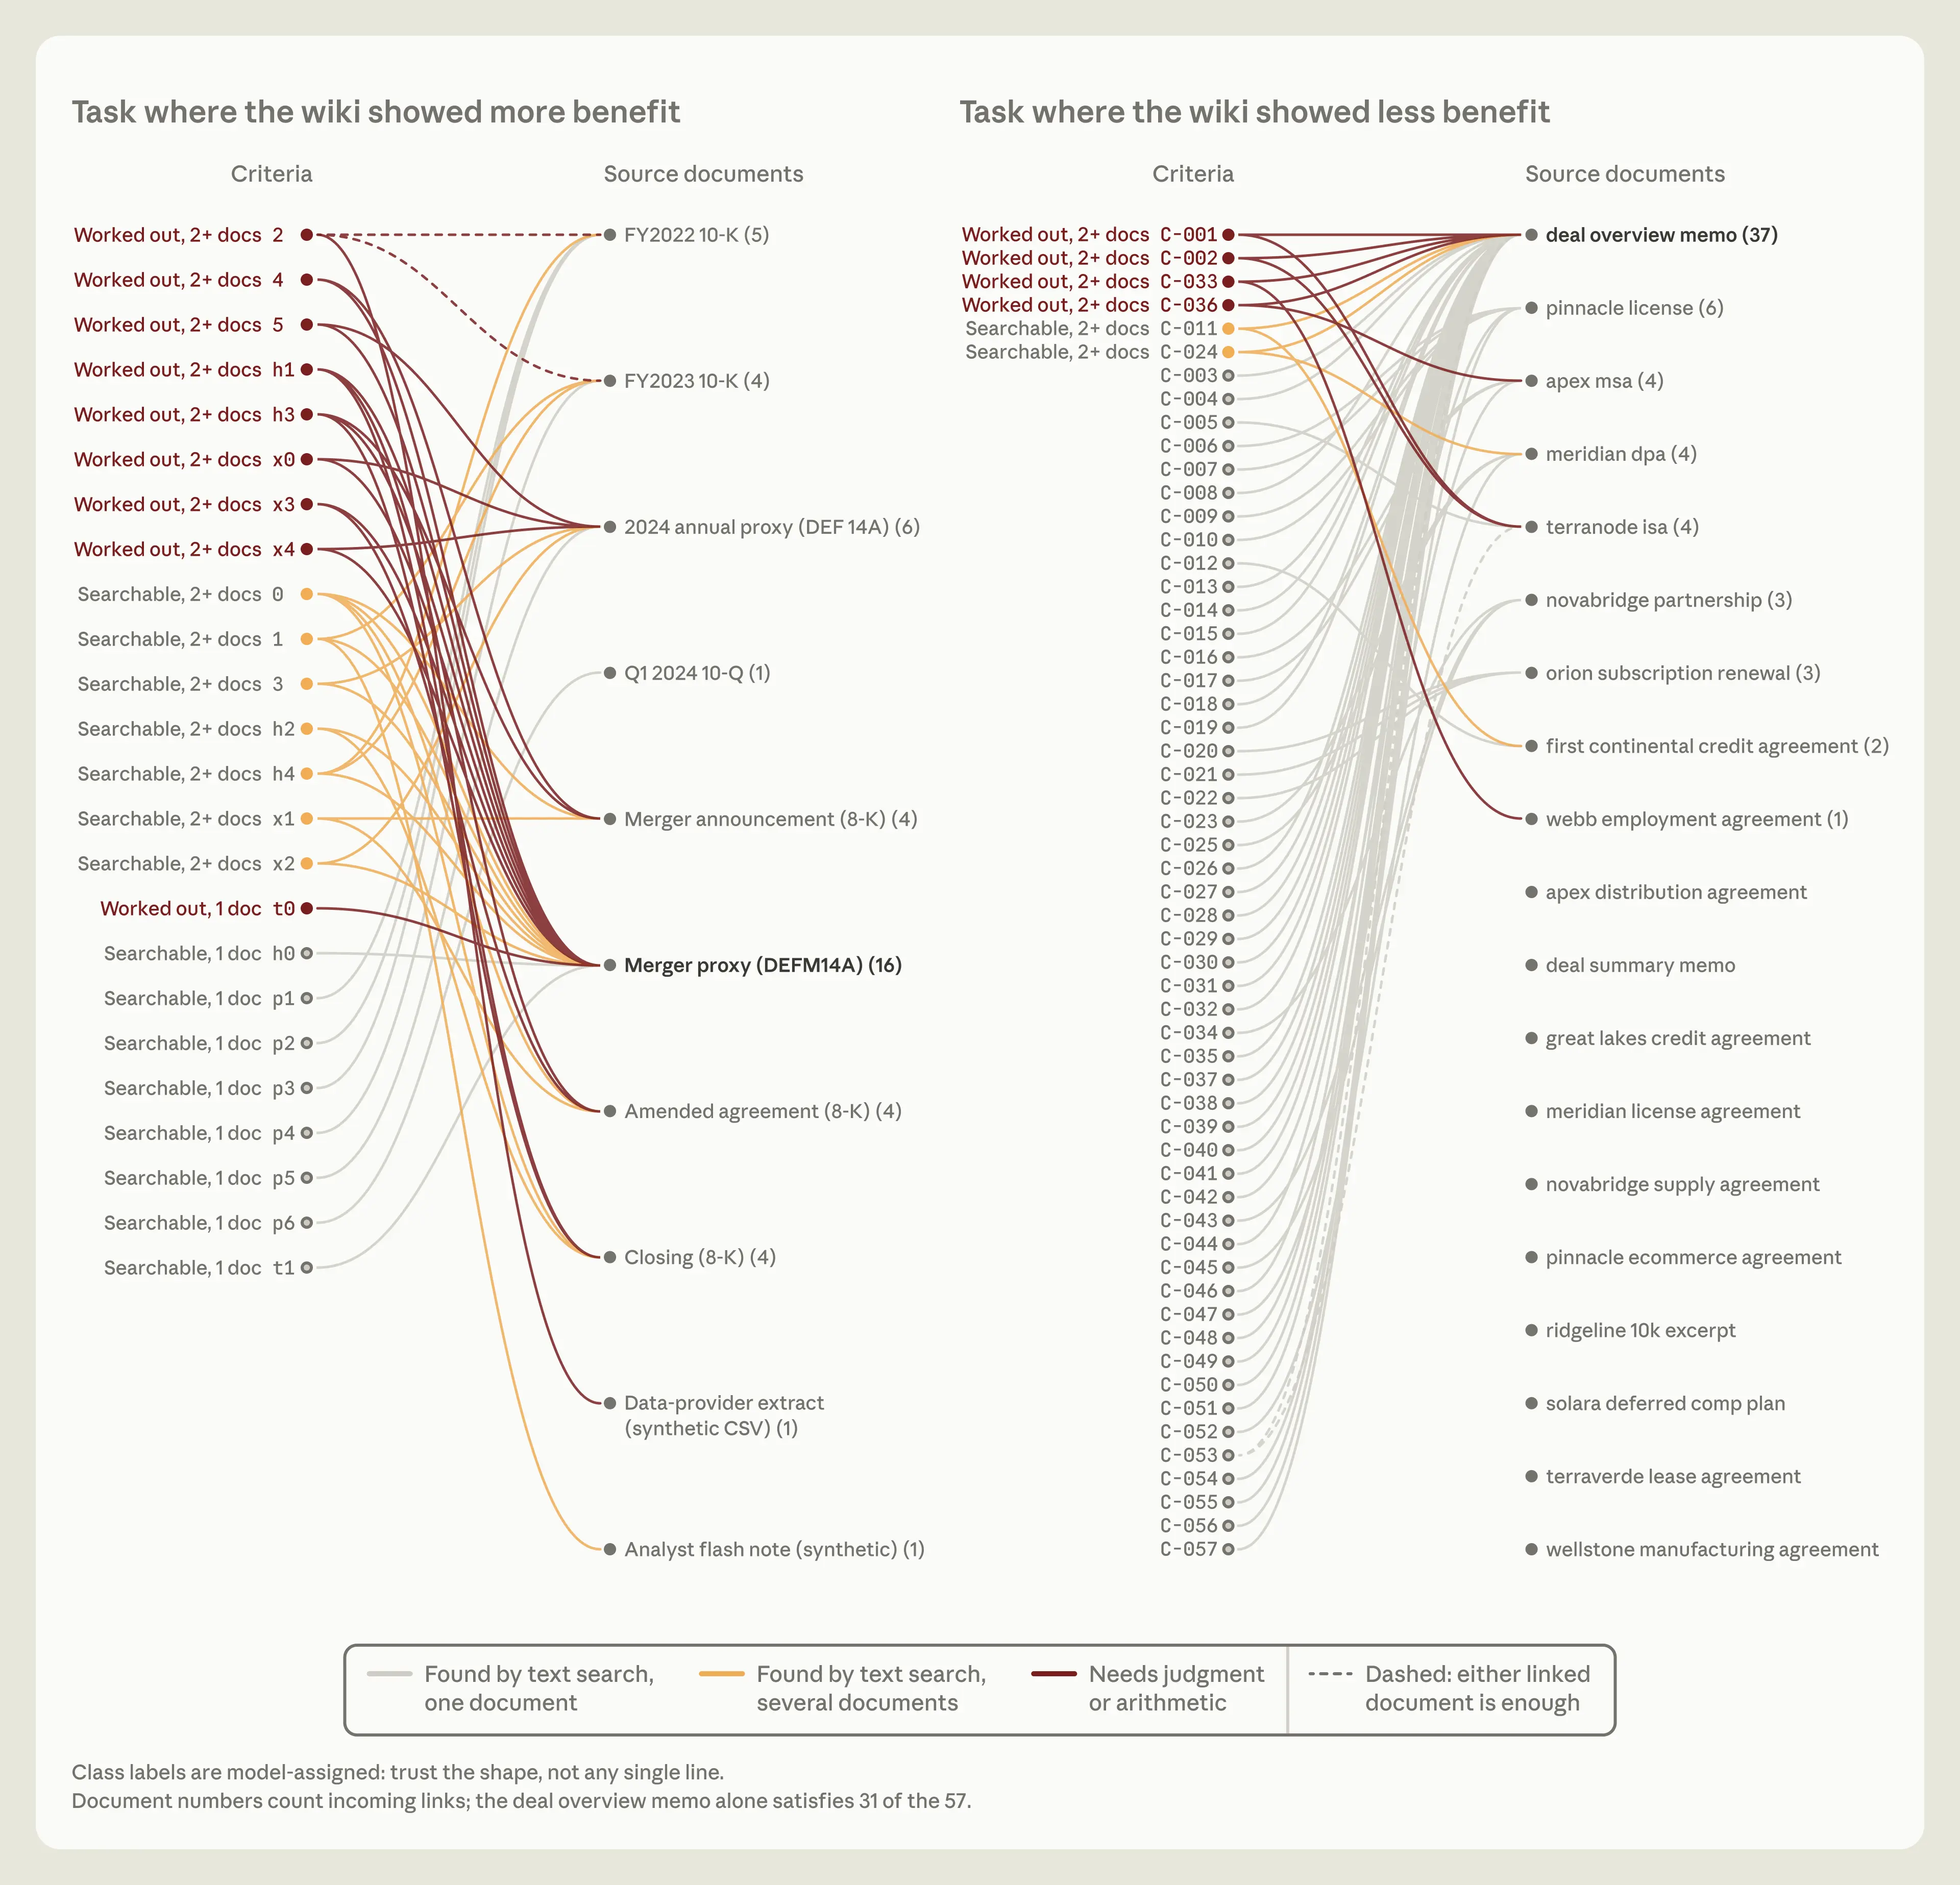
左侧:24 个关于合并的问题,这些问题主要可以通过查阅公开文件来解答。超过一半的评分标准需要结合多个文件中的信息。
右侧:一项 LAB 任务, wiki 并未显示出明显的优势。大多数评分标准都可以从单个文件中得到满足。
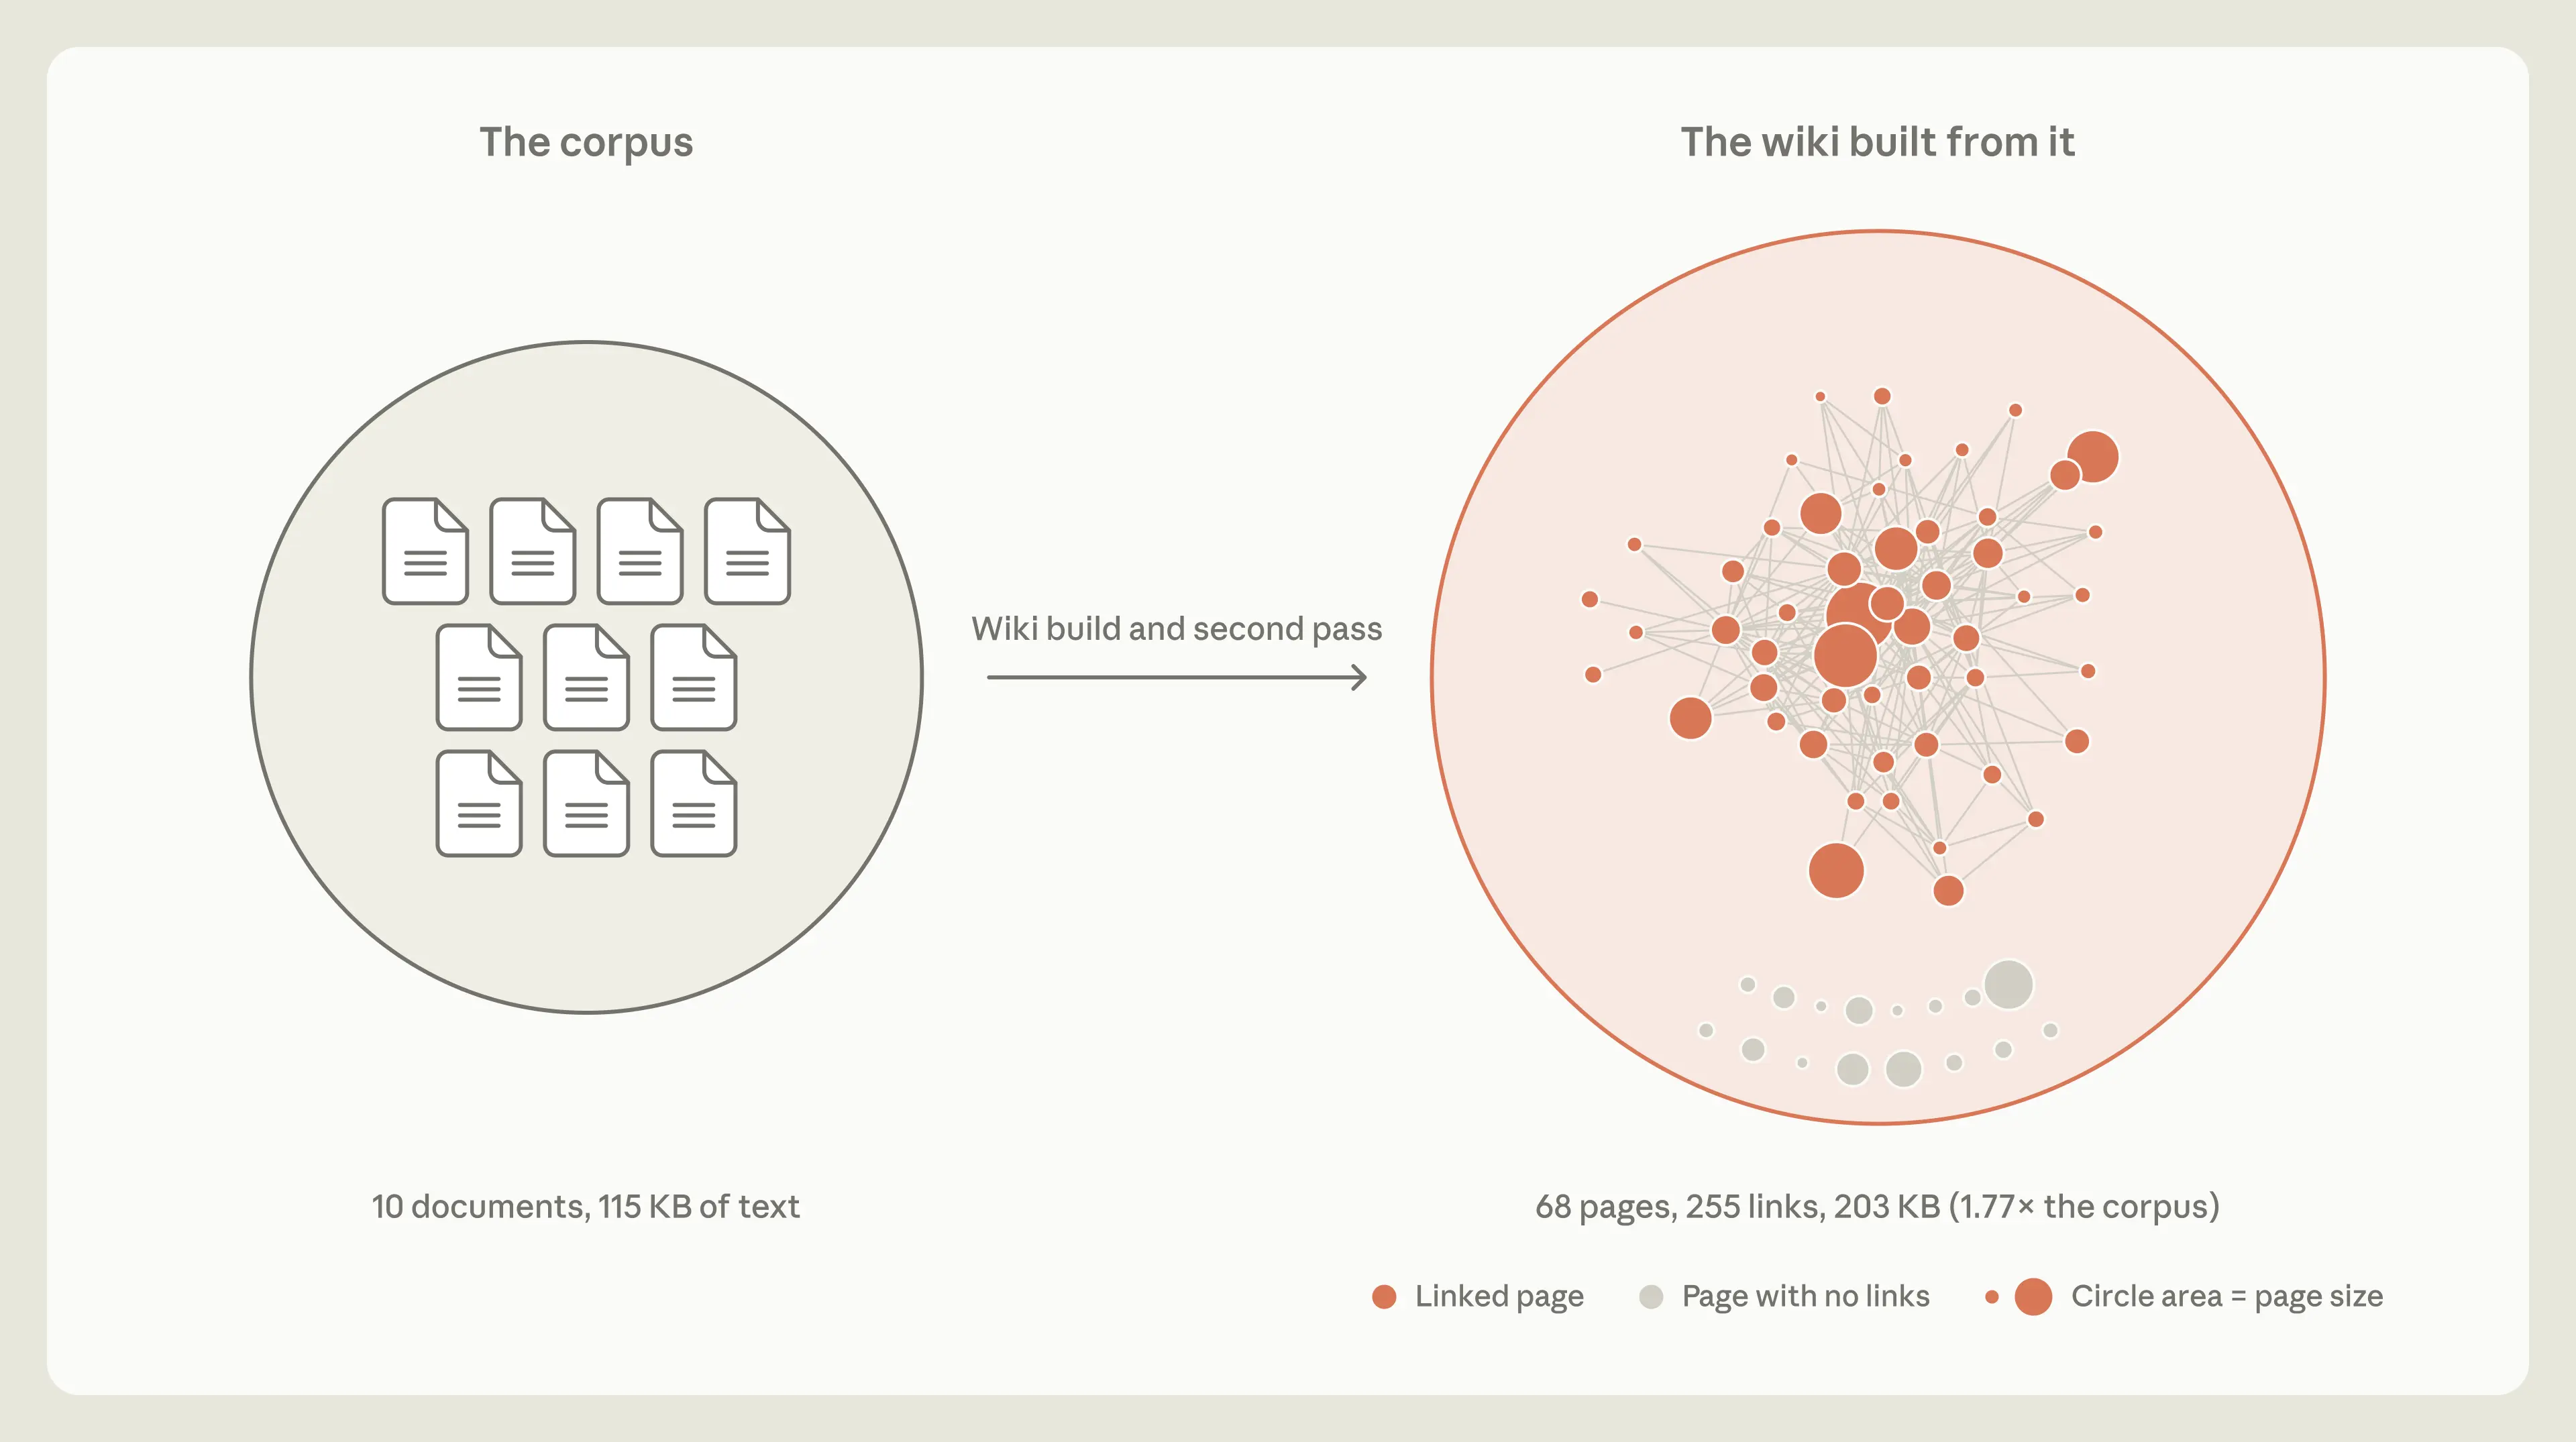
在其他情况下,维基的作用就不那么大了。在一项实验室任务中(图 11,右),通常只需从单个文档中进行文本搜索即可检索到简要的判断标准,维基在性能上并没有比搜索有明显的优势。在另一项实验室任务中,维基的规模甚至超过了文档本身(图 12)。就像博尔赫斯在短篇小说《论科学的精确性》中描绘的地图绘制者一样,他们绘制的地图极其详尽,以至于其规模与所代表的帝国一样庞大,Claude也制作了一个极其详尽的维基,但实际上却没有任何抽象之处。
做梦可以促进记忆层级中记忆点的上升
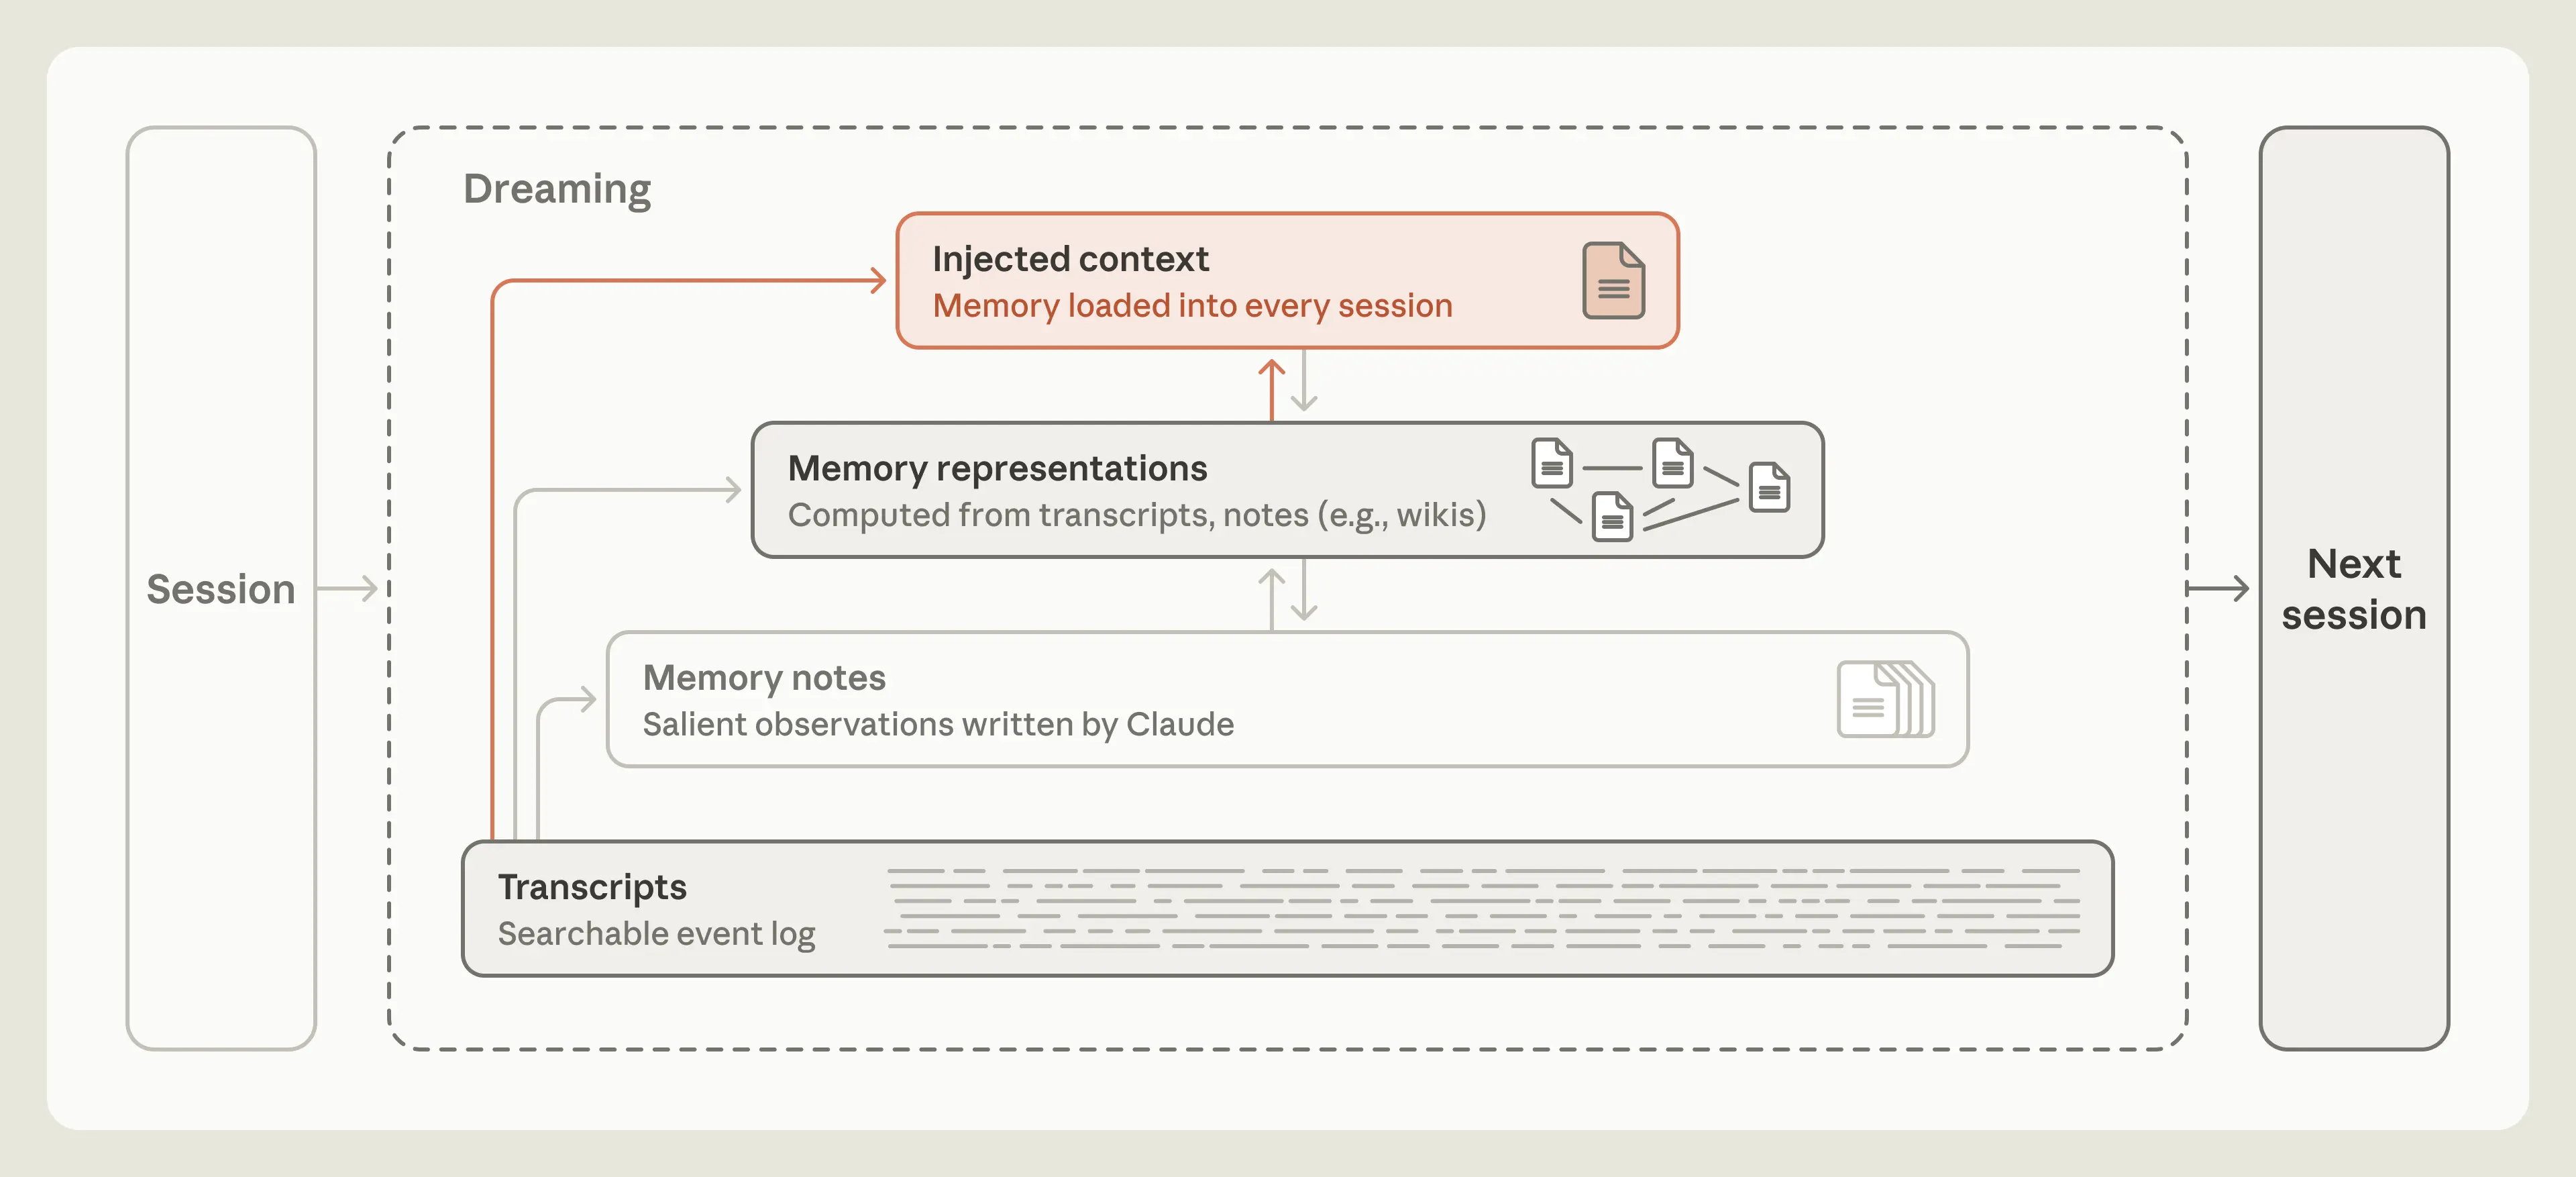
梦境还可以将笔记置顶到记忆层级的顶端,智能体 harness 可以在每次会话开始时预先将它们加载到Claude的上下文中(图 13)。这意味着Claude无需搜索它们,甚至无需知道有什么东西需要搜索。
将记忆提升到新的会话中(一种上下文注入)必须谨慎操作。注入的记忆会消耗宝贵的 token,而且错误的笔记可能会被带入每个会话。加载笔记也不能保证Claude会执行它:我们关于Claude代码的文档警告说,较长的指令文件会降低指令的执行率。因此,记忆层次结构的顶层必须保持相对较小,而梦境的大部分工作就是维持这种状态——通过将一些细节向下移动到层次结构中,并留下一些链接。
Claude Code 的自动记忆管理机制也以同样的方式保持其注入层的大小,Claude 会在会话期间维护它。Claude 不会将所有自动记忆都加载到每个会话的上下文窗口中,而只会加载前 200 行或 25 KB 的内容 MEMORY.md。这个头部信息充当索引,向 Claude 指示它知道哪些内容以及在哪里可以找到它们。
做梦可以将记忆集中在特定目标上
梦境也能影响记忆的形成。例如,像 Claude Duet 这样的助手,通常会受益于围绕其服务对象而组织的记忆,而梦境可以被调整以构建服务于特定目标的记忆。
指导记忆增长的指令因任务而异,并告诉Claude哪些信息才是真正重要的。例如,LAB 基准测试中的一项任务模拟公司收购,并提供一系列合同。评分标准是任务简报是否正确描述了合同条款。
我们首先提供了生成维基的基本指令,但并未告诉Claude如何使用该维基。这项任务很大程度上依赖于合同条款。在维基构建过程中,多个智能体同时向一个共享的合同条款表中写入信息(图 14,左)。
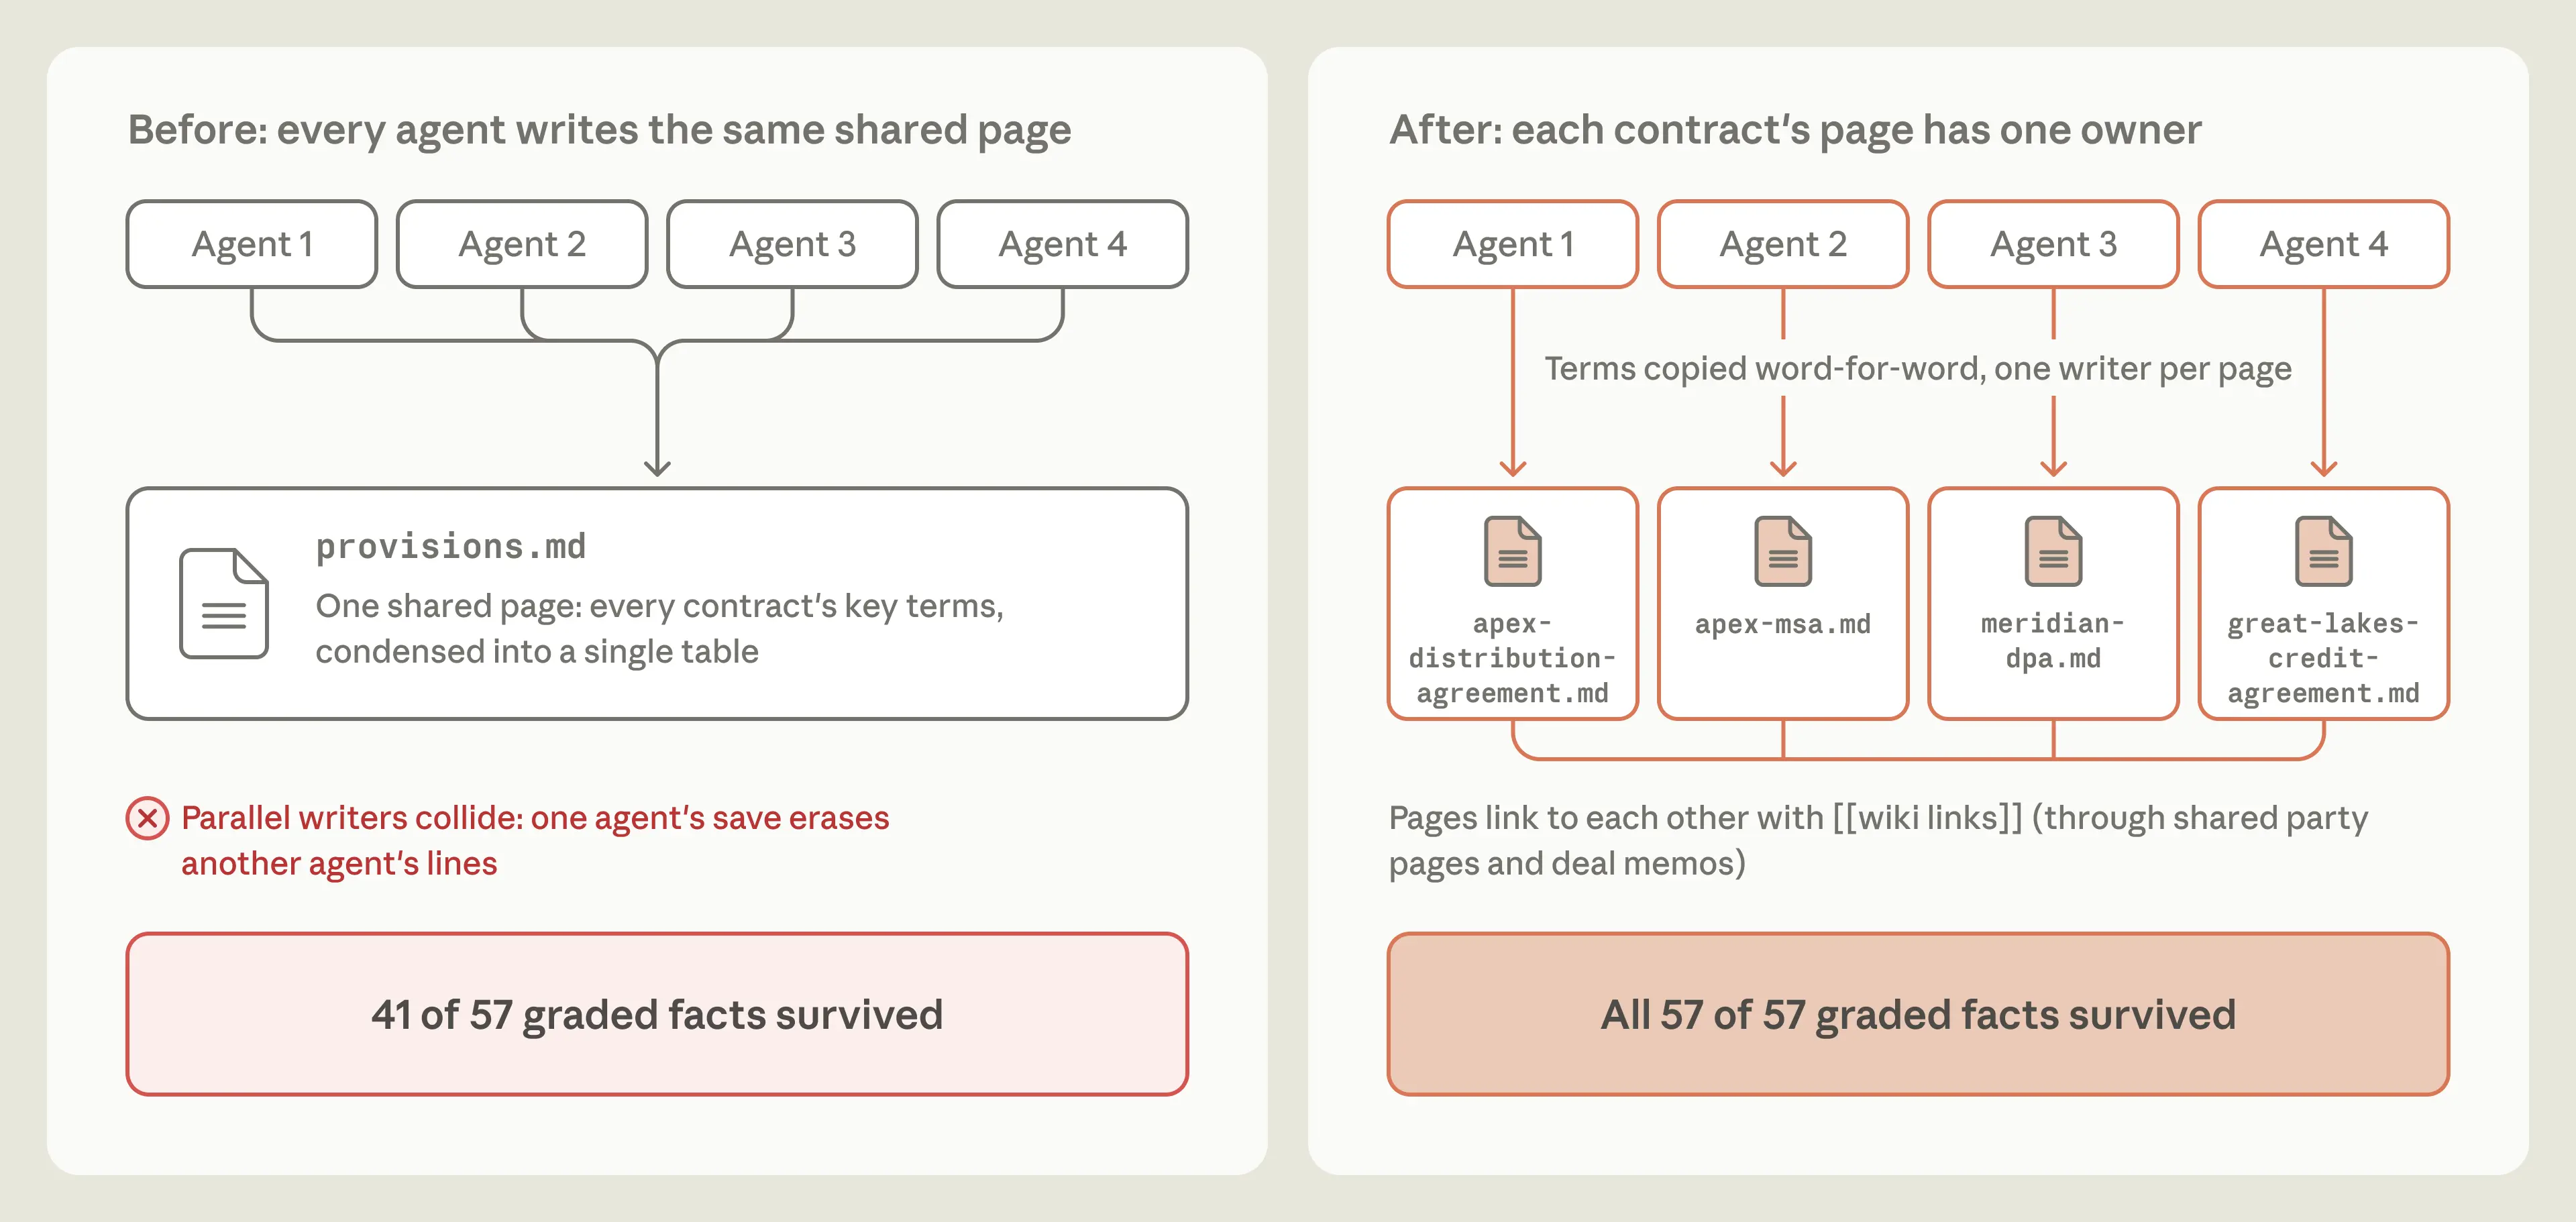
左图:多名智能体共同撰写一个页面;57 条条款中有 41 条被保留。
右图:每个智能体负责一份合同,各自撰写自己的页面并逐字引用条款;57 条条款全部被保留。
最终生成的维基页面缺少关键信息。当我们对根据该维基页面生成的简报进行评分时,Claude只包含了57个事实中的41个(72%)。当我们分析问题所在时,发现共享表格对合同条款的总结不够完善,甚至完全遗漏了一些条款,原因是智能体之间互相覆盖了彼此的工作。
合同条款是 wiki最重要的部分,但说明文档中并没有提到这一点。为了找到更好的说明文档,我们设计了一个循环:Claude反思 wiki 的不足之处,提出修改建议,然后重新构建 wiki 。这个循环让Claude意识到遵守合同条款的重要性,并据此重写了 wiki 的构建说明文档。
每份合同在 wiki 上都有自己的页面,由一位智能体撰写,页面逐字引用合同条款,而不是将其汇总到共享表格中。当我们对基于改进后的 wiki 生成的简报进行评分时,所有标准均已达到,比之前的72%有所提高。
做梦可以填补疗程留下的空白
当Claude记录记忆笔记时,它只能看到特定梦境的上下文。而梦境则可以跨越多个梦境进行搜索,以寻找共同模式或纠正常见错误。
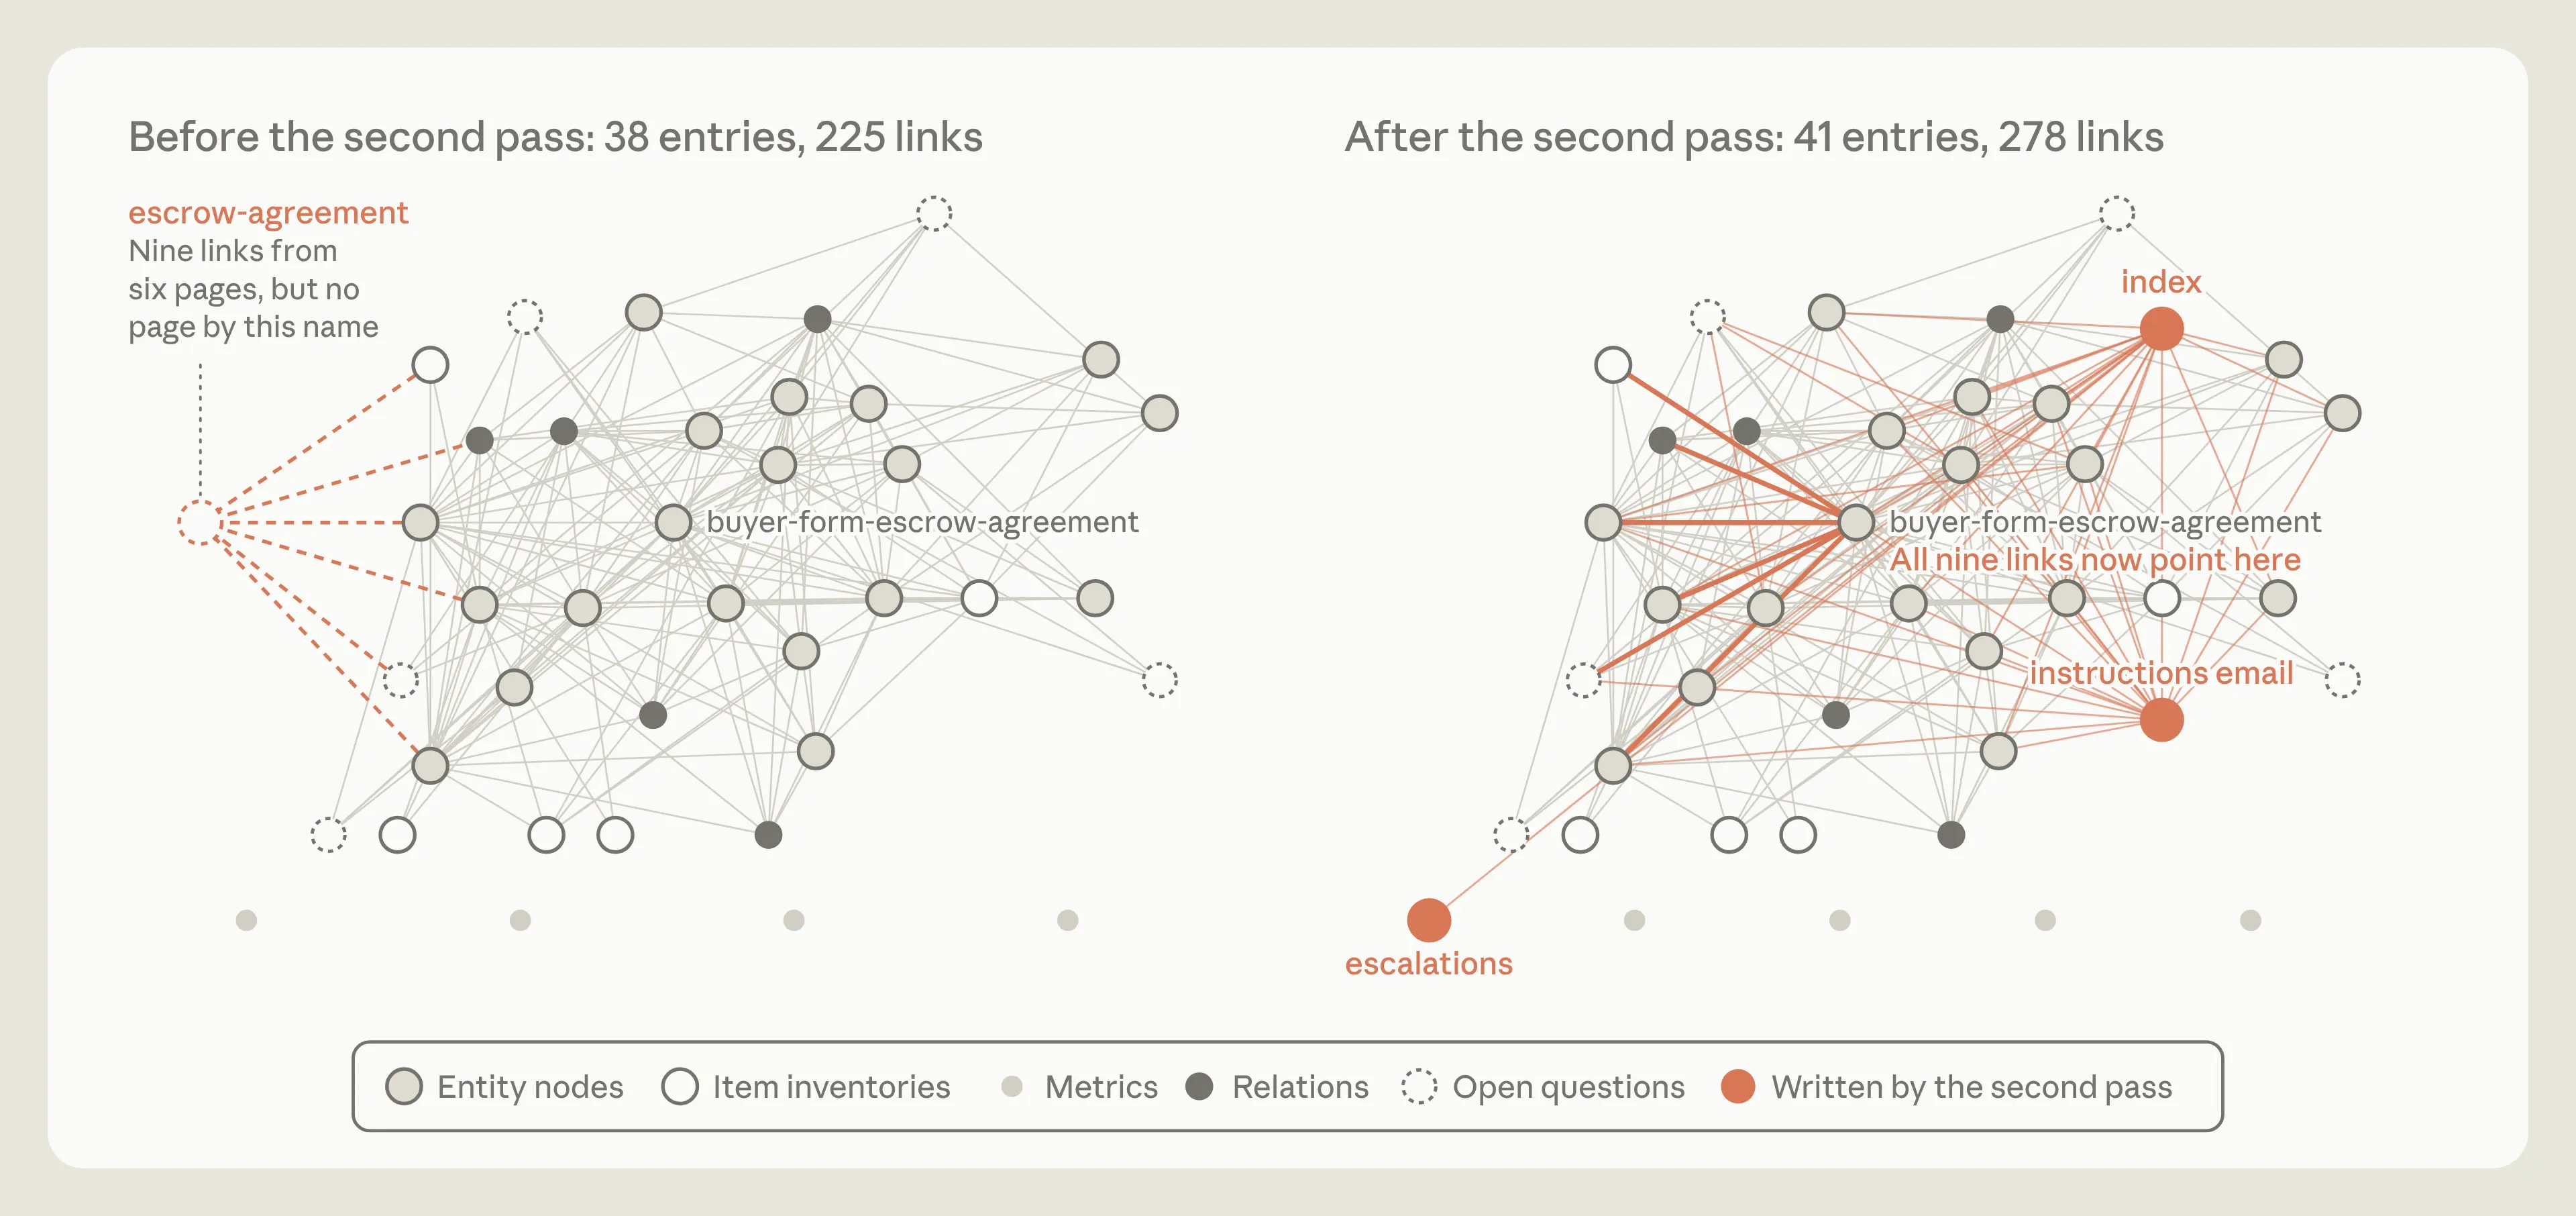
在构建 LAB 基准测试的 wiki 时(例如,参见图 14),Claude 有时会链接到尚未创建的页面。第二次模拟运行弥补了许多此类缺陷。在一个任务中(图 15),模拟运行发现了 9 个指向 wiki 中缺失页面的链接,并将它们重新指向同一文档的现有页面。此外,它还添加了三个新页面,包括一个索引,以改进 wiki。
回顾过去,展望未来
关于如何为智能体设计记忆系统,仍有许多悬而未决的问题。其中之 一是Claude何时应该创建记忆。当Claude执行任务时,它可以将信息写入记忆存储(例如文件夹、文件或数据库),从而在源头捕捉重要信息,并使重要细节能够立即用于后续回合或会话。但是,即时记录笔记不可避免地会分散Claude对主要任务的注意力。相比之下,做梦可以将记忆创建置于后台,但Claude可能无法立即访问梦境的任何输出。
另一个问题是如何确保记忆始终保持最新。Claude可能会做出错误的预测,或者一开始就将错误的规则写入记忆。随着环境的变化,记忆也会发生漂移,变得无关紧要。做梦是修正这些错误的一种方法(图 8),但这需要计算能力。让Claude持续检查所有记忆可能并不实际。因此,或许应该将做梦的重点放在可能发生变化的信息上,或者仔细调整做梦的频率(例如,根据记忆被访问的频率)。
将转录文本搜索视为Claude记忆的基础也是合理的。将各种表征形式(例如 wiki)与搜索功能(图 10)相结合有时会很有效。但Claude需要利用计算能力来维护记忆表征,并确保它们不会累积错误或产生幻觉。
尽管Claude对显著性的判断有所提高,但任何模型都无法真正预知未来会发生什么。做梦让Claude有机会回顾过去,并利用计算能力来整理记忆、纠正错误,以及维护便于未来会话更便捷地访问记忆的表征。随着Claude能力的提升,记忆系统也会不断演进,而我们对Claude记忆系统的设计仍有很多需要学习的地方。