选自Medium,作者:Leon Fedden

原文链接:https://medium.com/@LeonFedden/comparative-audio-analysis-with-wavenet-mfccs-umap-t-sne-and-pca-cb8237bfce2f

机器之心编译,参与:Nurhachu Null、刘晓坤

这篇文章基于 GitHub 中探索音频数据集的项目。本文列举并对比了一些有趣的算法,例如 Wavenet、UMAP、t-SNE、MFCCs 以及 PCA。此外,本文还展示了如何在 Python 中使用 Librosa 和 Tensorflow 来实现它们,并用 HTML、Javascript 和 CCS 展示可视化结果。

作者希望能和我们分享两个代码库。第一个是用来制作这篇文章的 notebook,它不像我通常喜欢的那样精美,但是花了很长时间,读者可以随意使用并扩展它。

此外,作者也上传了浏览器中的这些可视化代码到 github 上。他使用 Material Design Lite 库以相对简洁的方式创建用户界面,用 THREE.js 库来快速绘制数据并进行优化,还使用 webaudiox.js 可以让音频生成得更容易。

文章从用户生命周期的四个阶段并贴合活跃这一维度,罗列了Pinterest内部关注的20多项指标。从Pinterest我们可以延伸至内容类产品来看待这些指标,因为和电商、互金等产品相比,活跃的波动对内容类产品有着更直接的影响。为了便于理解,文章最终提炼出了19项指标并部分添加了描述和解读,供参考。

文章内容可能会相对比较多,读者可以点击上方目录,直接阅读自己感兴趣的章节。

1.序

关于xgboost的原理网络上的资源很少,大多数还停留在应用层面,本文通过学习陈天奇博士的PPT、论文、一些网络资源,希望对xgboost原理进行深入理解。(笔者在最后的参考文献中会给出地址)

2.xgboost vs gbdt

说到xgboost,不得不说gbdt,两者都是boosting方法(如图1所示),了解gbdt可以看我这篇文章 地址。

图1

FM和FFM模型是最近几年提出的模型,凭借其在数据量比较大并且特征稀疏的情况下,仍然能够得到优秀的性能和效果的特性,屡次在各大公司举办的CTR预估比赛中获得不错的战绩。美团点评技术团队在搭建DSP的过程中,探索并使用了FM和FFM模型进行CTR和CVR预估,并且取得了不错的效果。本文旨在把我们对FM和FFM原理的探索和应用的经验介绍给有兴趣的读者。

前言

在计算广告领域,点击率CTR(click-through rate)和转化率CVR(conversion rate)是衡量广告流量的两个关键指标。准确的估计CTR、CVR对于提高流量的价值,增加广告收入有重要的指导作用。预估CTR/CVR,业界常用的方法有人工特征工程 + LR(Logistic Regression)、GBDT(Gradient Boosting Decision Tree) + LR[1][2][3]、FM(Factorization Machine)[2][7]和FFM(Field-aware Factorization Machine)[9]模型。在这些模型中,FM和FFM近年来表现突出,分别在由Criteo和Avazu举办的CTR预测竞赛中夺得冠军[4][5]。

很多朋友很想知道神策分析(Sensors Analytics)是如何实现在每天十亿级别数据的情况下可以做到秒级导入和秒级查询,是如何做到不需要预先指定指标和维度就能实现多维查询的。今天正好在这篇文章里面,和大家交流一下我们的技术选型与具体的架构实现,希望能够对大家有所启发。

当然,脱离客户需求谈产品设计,不太现实;而脱离产品设计,纯粹谈技术选型与架构实现,也不现实。因此,我们首先会跟大家探讨一下神策分析从产品角度,是如何从客户需求抽象产品设计的,而产品设计,又是如何确定我们的技术选型。然后,我们则会从产品的整体架构出发,逐步介绍每一个模块和子系统的具体实现。

Hive是基于Hadoop平台的,它提供了类似SQL一样的查询语言HQL。有了Hive,如果使用过SQL语言,并且不理解Hadoop MapReduce运行原理,也就无法通过编程来实现MR,但是你仍然可以很容易地编写出特定查询分析的HQL语句,通过使用类似SQL的语法,将HQL查询语句提交Hive系统执行查询分析,最终Hive会帮你转换成底层Hadoop能够理解的MR Job。

对于最基本的HQL查询我们不再累述,这里主要说明Hive中进行统计分析时使用到的JOIN操作。在说明Hive JOIN之前,我们先简单说明一下,Hadoop执行MR Job的基本过程(运行机制),能更好的帮助我们理解HQL转换到底层的MR Job后是如何执行的。我们重点说明MapReduce执行过程中,从Map端到Reduce端这个过程(Shuffle)的执行情况,如图所示(来自《Hadoop: The Definitive Guide》):

精准化营销一直以来都是互联网营销业务在细分市场下快速获取用户和提高转化的利器。在移动互联网爆发的今天,数据量呈指数增长,如何在移动和大数据场景下用数据驱动进行精准营销,从而提高营销效能,成为营销业务部门的主要挑战之一,同时也是大数据应用的一个重要研究方向。本文通过数据体系架构和技术实现案例,分享美团大众点评数据应用团队在这个方向上的一些尝试和实践经验。

总体框架

在介绍数据体系和框架前,为了方便大家理解,先简单阐述一下O2O营销的基本组成:O2O营销是由营销发生的渠道(站内,站外)与营销的主题业务(流量,交易)两个维度组成的,其中产生了多种营销的形态,如精准化用户营销活动、DSP的精准投放、渠道价值排名和反作弊等,数据分析和挖掘在这些环节都能发挥很大的价值。本文主要阐述站内的精准化用户营销活动。

一个站内用户运营活动的生命周期大概可以归纳为:确定目标、选取活动对象、设计活动方案、活动配置与上线、线上精准营销与动态优化以及效果监控与评估六个环节。如下图所示。

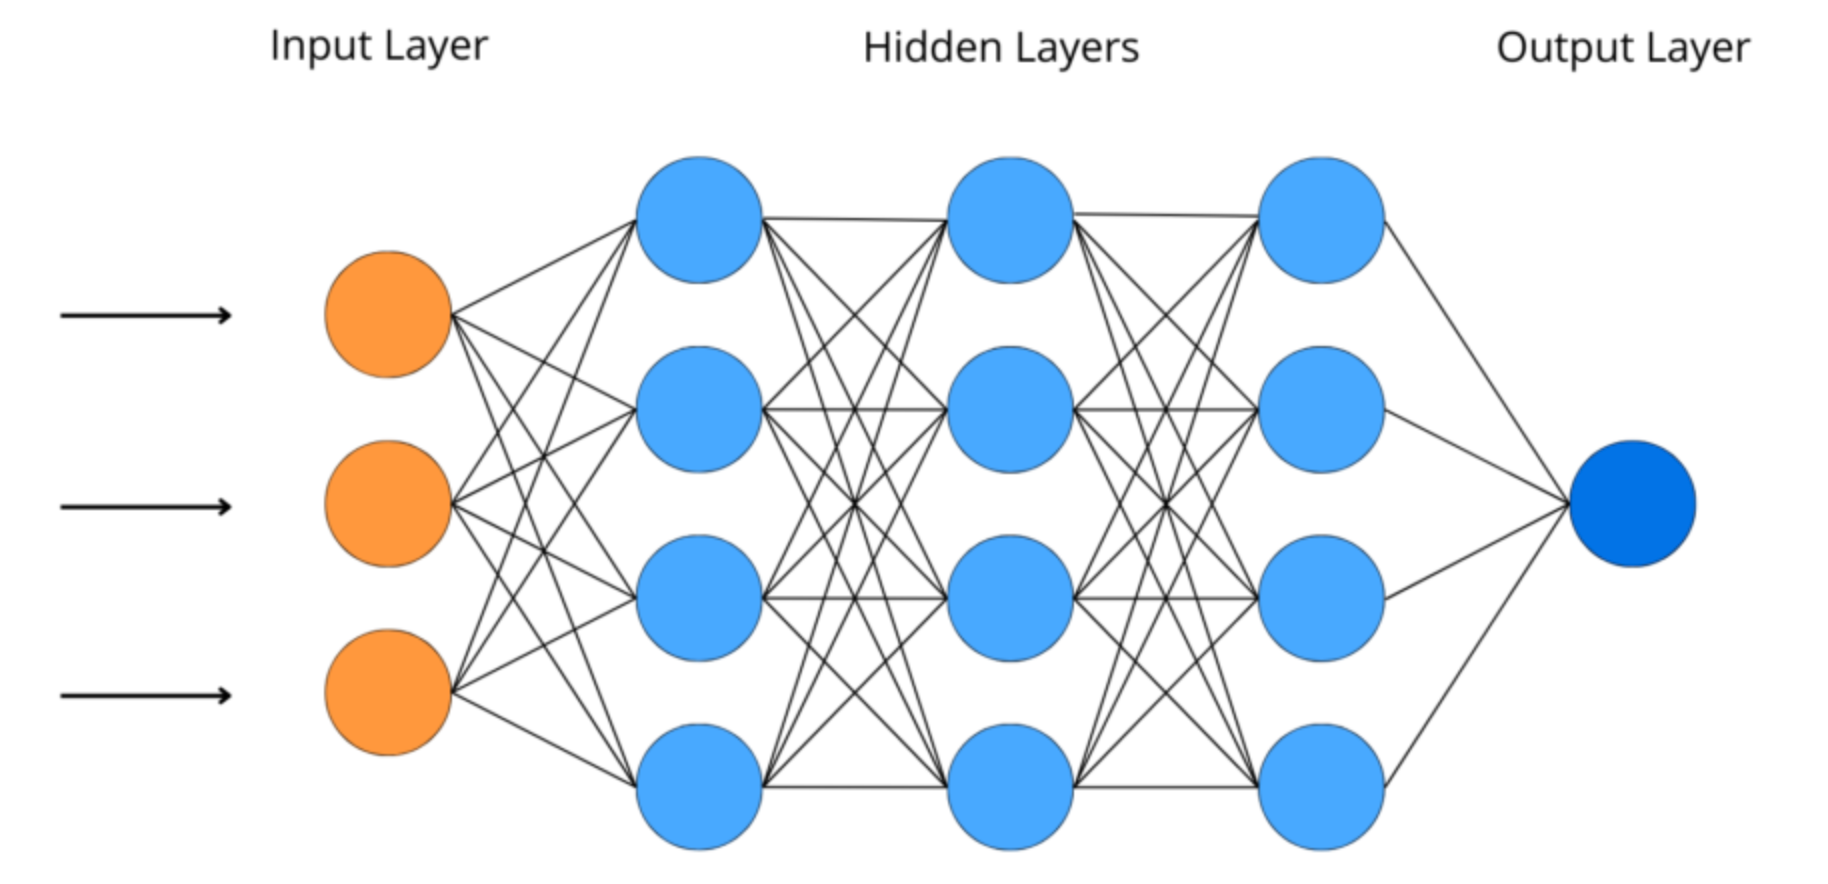
一、神经网络中隐层数和隐层节点数问题的讨论

1.1 隐层数

一般认为,增加隐层数可以降低网络误差(也有文献认为不一定能有效降低),提高精度,但也使网络复杂化,从而增加了网络的训练时间和出现“过拟合”的倾向。一般来讲应设计神经网络应优先考虑3层网络(即有1个隐层)。一般地,靠增加隐层节点数来获得较低的误差,其训练效果要比增加隐层数更容易实现。对于没有隐层的神经网络模型,实际上就是一个线性或非线性(取决于输出层采用线性或非线性转换函数型式)回归模型。因此,一般认为,应将不含隐层的网络模型归入回归分析中,技术已很成熟,没有必要在神经网络理论中再讨论之。

这是很早前(2012年底)小龙在腾讯内部的8h分享,15年下半年有个一起封陪的小伙伴离职创业了,离职前在朋友圈提到了了这个分享,才知道有这个仅内部的闭门分享,于是也完整的听了一遍,做了一些关键信息的笔记。在很长一段时间里,这个分享都没有对外公开的资料,最近看到一个相对完整的资料是15年9月的这个:164页PPT。

以下是我个人观看的笔记:

微信背后的产品观——张小龙,2012年8月,准备了半年,平时的想法记录。

微信回顾

✔433天,1亿用户。10年11月19日立项,11年1月发布1.0,5月2.0,10月3.0,12年4月4.0
✔成为移动互联网新入口

Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用。美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析。Hive的稳定性和性能对我们的数据分析非常关键。

在几次升级Hive的过程中,我们遇到了一些大大小小的问题。通过向社区的咨询和自己的努力,在解决这些问题的同时我们对Hive将SQL编译为MapReduce的过程有了比较深入的理解。对这一过程的理解不仅帮助我们解决了一些Hive的bug,也有利于我们优化Hive SQL,提升我们对Hive的掌控力,同时有能力去定制一些需要的功能。